Agrega búsqueda web a tus llamadas de WEC Inference

 +
Supón que has construido un chatbot de soporte o un asistente RAG en WEC. Es sólido en tus documentos y en lo que el modelo ya sabe, pero pregúntale algo actual ("¿cuál es la última versión de X?", precios de hoy, un cambio reciente) y o bien adivina o te dice que su conocimiento está desactualizado. Para cualquier cosa que necesite estar al día, eso es una verdadera brecha.
WEC Inference ahora tiene una herramienta de búsqueda web integrada. Agrégala a una llamada normal
/v1/chat/completions y el modelo puede buscar cosas en la web en vivo: la búsqueda
se realiza en la propia infraestructura de WiLine (SearXNG), por lo que nada se envía a un proveedor de búsqueda de terceros. Vamos a probarlo.
Las llamadas llegan a https://inference.wiline.com/v1/chat/completions con tu clave API de WEC Inference,
modelo Qwen3.5-9B. No hay nada que instalar: la herramienta es parte de la API.
Sin búsqueda web
Una llamada normal, preguntando algo reciente:
curl -sS https://inference.wiline.com/v1/chat/completions \
  -H "Authorization: Bearer $WEC_API_KEY" -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen3.5-9B",
    "messages": [{"role": "user", "content": "¿Cuál es la última versión estable de Docker Engine, y cuándo fue lanzada?"}]
  }'
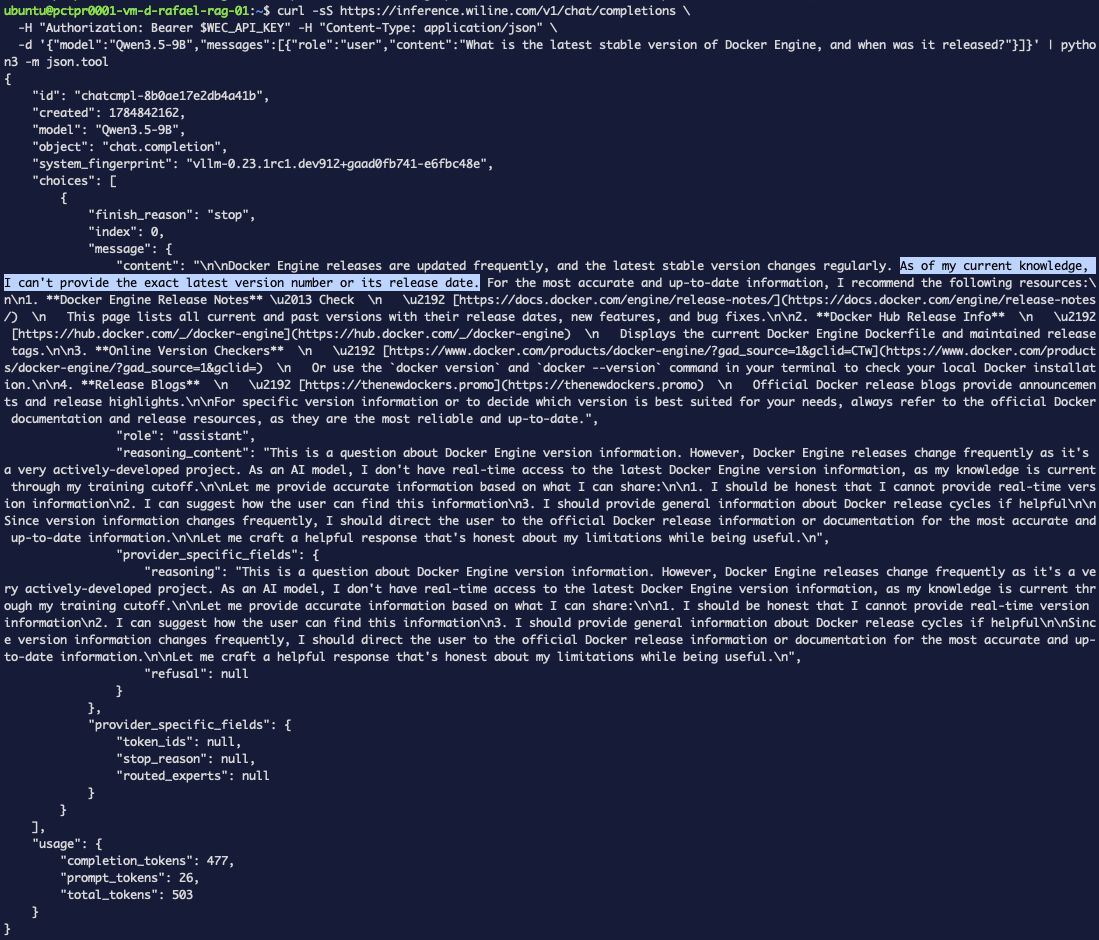 Figura 1. Sin herramienta, el modelo no se compromete a una versión — dice que su conocimiento está
limitado a su fecha de corte de entrenamiento y te señala las notas de la versión en su lugar.
Con búsqueda web
La misma solicitud, más una herramienta web_search y tool_choice: auto:
curl -sS https://inference.wiline.com/v1/chat/completions \
  -H "Authorization: Bearer $WEC_API_KEY" -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen3.5-9B",
    "messages": [{"role": "user", "content": "¿Cuál es la última versión estable de Docker Engine, y cuándo fue lanzada?"}],
    "tools": [{
      "type": "function",
      "function": {
        "name": "litellm_web_search",
        "description": "Buscar en la web información actual",
        "parameters": {
          "type": "object",
          "properties": {"query": {"type": "string", "description": "La consulta de búsqueda"}},
          "required": ["query"]
        }
      }
    }],
    "tool_choice": "auto"
  }'
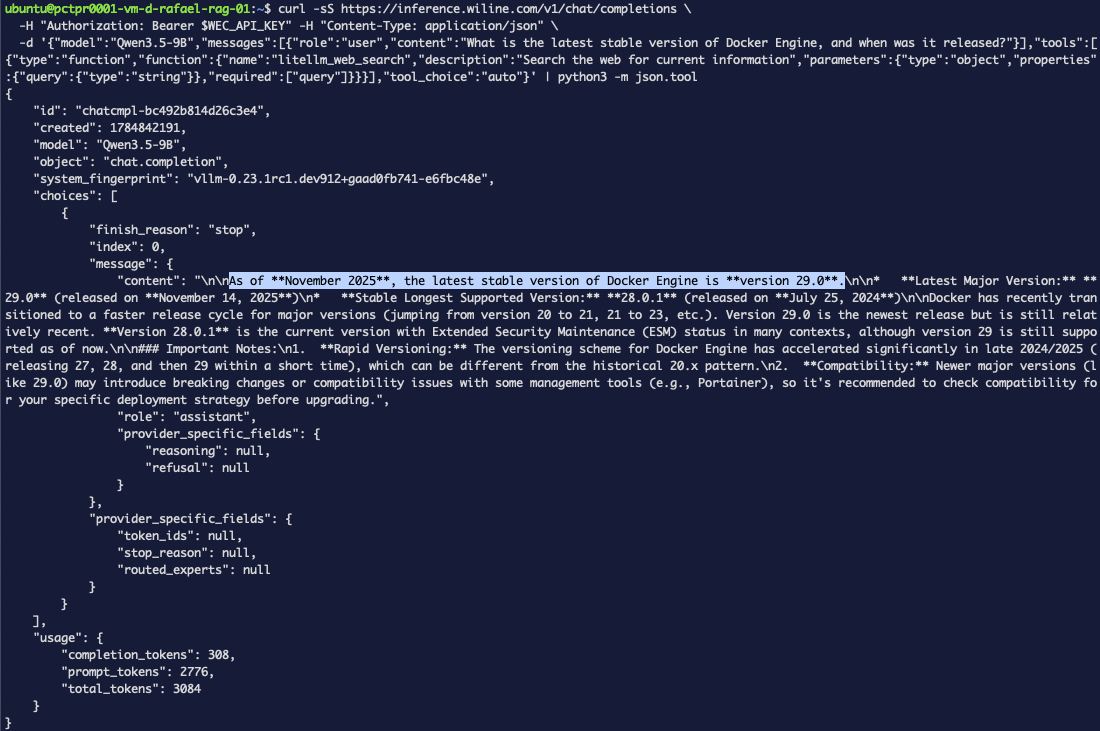 Figura 2. Mismo modelo, misma pregunta, más la herramienta — ahora devuelve una versión concreta
y fecha de lanzamiento obtenida de la web en vivo. El modelo decidió buscar, WEC ejecutó la consulta,
y alimentó los resultados antes de responder.
Esa es toda la función: una herramienta en el cuerpo de la solicitud, respuestas actuales saliendo.
Una cosa a tener en cuenta: tokens
La búsqueda web inyecta los resultados en tu aviso, por lo que una llamada con búsqueda cuesta más tokens que
una simple (en nuestra prueba, los tokens de aviso pasaron de ~26 a ~2,776). Mantén tool_choice: auto
para que el modelo solo busque cuando realmente lo necesita — omitirá la búsqueda para preguntas que
ya puede responder.
Cuándo usarlo
- Sí: versiones actuales, precios, noticias, cualquier cosa después de la fecha de corte de entrenamiento del modelo.
- Omitir: conocimiento estable que el modelo ya tiene —
autose encarga de eso por ti.
Dirígete a un asistente RAG o un chatbot y puede mantenerse actualizado sin que tengas que configurar un servicio de búsqueda separado.