Aísla el código que escribe tu agente y comprueba que cada límite se aplicó de verdad

- 1Lock down Docker networks
- 2Run containers as non-root
- 3Identity in front of every port
- 4Membership, not just an account
- 5An identity for the agent, not a key
- 6A tool server that checks who is asking
- 7Where the agent can go, not just what it can call
- 8Move the daemon off root
- 9Run the model's own code without trusting it
- 🏆A scope per tool, and a refusal clients can act on
Todas las partes de esta serie hasta ahora le han dado al modelo herramientas: funciones que escribiste tú, con argumentos que definiste tú. Este post va sobre la otra cosa que hacen los agentes, que es escribir código y después ejecutarlo.
Es un riesgo distinto, y vale la pena ser preciso sobre la diferencia. Una llamada a herramienta es el modelo eligiendo de un menú que tú controlas. Ejecutar código generado es el modelo pasándote algo que nadie ha leído nunca, y que tú ejecutas en tu máquina.
Una WEC Instance: 8 vCPU AMD EPYC 7601, 15 GB de RAM, Ubuntu 22.04, kernel 5.15, systemd 249.
Docker rootless 29.8.1 de la Parte 8, corriendo
junto al demonio del sistema. La imagen de prueba es python:3.12-alpine. El host mantuvo 20
contenedores en marcha durante todo el proceso.
Todas las cifras y mensajes de error de abajo provienen de esa ejecución.
Por qué esto merece su propio post
La industria tiene un nombre para esto. El riesgo LLM05:2025 Improper Output Handling de OWASP lo lista como ejemplo de vulnerabilidad, con estas palabras:
LLM output is entered directly into a system shell or similar function such as exec or eval, resulting in remote code execution.
Y su consejo sobre cómo pensar en el modelo es exactamente el correcto:
Treat the model as any other user, adopting a zero-trust approach
Pero aquí está lo que hace que esa página merezca una lectura atenta. Te dice que trates la salida del modelo como no confiable, nombra la ejecución de código como la consecuencia, y después su sección de prevención habla únicamente de validar texto: codificación de salida, consultas parametrizadas, políticas de seguridad de contenido, monitoreo.
Busca en esa página sandbox, container, least privilege o isolation y obtienes cero resultados. No pocos. Ninguno.
No es una crítica a OWASP; el riesgo trata sobre el manejo de la salida, y validar es la respuesta correcta para una salida que se convierte en HTML o SQL. Pero cuando la salida es un programa que estás a punto de ejecutar, validar deja de ser posible. No puedes averiguar con una expresión regular si cien líneas de Python son seguras.
Así que la guía nombra el problema y se detiene una capa por encima del arreglo. Este post es esa capa.
Lo que permite la versión obvia
La implementación ingenua es la que casi todo el mundo despliega primero, y parece responsable — al fin y al cabo el código corre en un contenedor:
docker -c rootless run --rm python:3.12-alpine python -c "<el código del modelo>"
Preguntémosle a ese contenedor hasta dónde llega.
docker -c rootless run --rm python:3.12-alpine python -c "
import os, urllib.request
print('uid inside     :', os.getuid())
print('can see host / :', sorted(os.listdir('/'))[:10])
try:
    r = urllib.request.urlopen('https://api.github.com', timeout=5)
    print('internet       : REACHED', r.status)
except Exception as e:
    print('internet       : blocked', type(e).__name__)
"

docker -c rootless run --rm python:3.12-alpine sh -c '
echo "memory limit : $(cat /sys/fs/cgroup/memory.max)"
echo "pids limit   : $(cat /sys/fs/cgroup/pids.max)"
echo "cpus visible : $(nproc)"
echo "writable fs  : $(touch /proc-test 2>/dev/null && echo yes || echo no)"
'
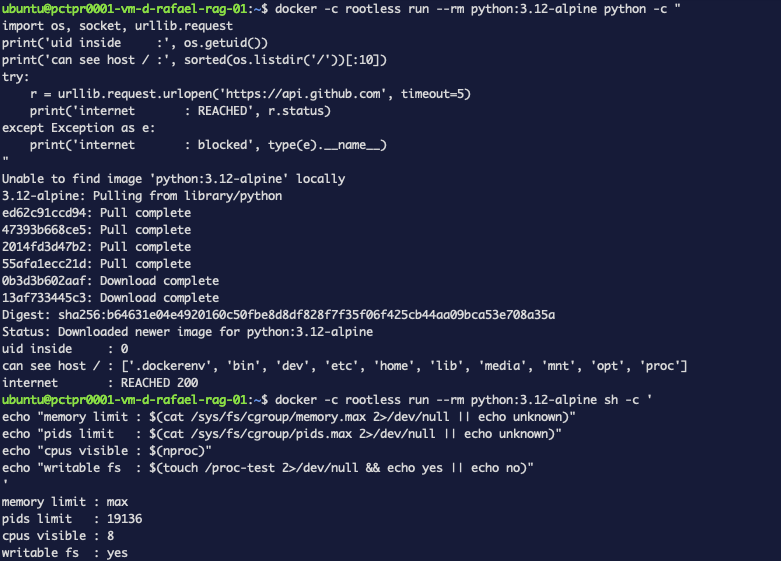
internet       : REACHED 200
memory limit : max
pids limit   : 19136
cpus visible : 8
writable fs  : yes
Léelo como la lista de lo que el código generado tiene permitido hacer en tu máquina:
- Llegar a internet. Cualquier cosa que encuentre, puede enviarla a algún sitio.
- Quedarse con toda la memoria.
maxsignifica sin límite. En este host son 15 GB, y el kernel empezará a matar otras cosas para proporcionarlos. - Arrancar 19.136 procesos. Suficiente para dejar el host inutilizable.
- Usar los ocho núcleos.
- Escribir en cualquier parte del contenedor, incluido llenar el disco.
La Parte 8 sacó al demonio de root, así que este código ya no puede quedarse con el host. Aquello valía la pena y aquí no ayuda en absoluto. Ninguno de los cinco puntos de arriba requiere ser root.
Cerrarlo
Docker tiene flags para cada uno de estos. No son vistosas y son el arreglo entero:
docker -c rootless run --rm \
  --network none --memory 256m --pids-limit 64 --cpus 0.5 \
  --read-only --tmpfs /tmp:size=16m \
  --cap-drop=ALL --security-opt no-new-privileges \
  python:3.12-alpine <comando>
En palabras llanas:
| Flag | Qué impide |
|---|---|
--network none | Sin red en absoluto — no se puede enviar nada a ninguna parte |
--memory 256m | Si usa más de 256 MB, el kernel lo mata a él, no a tus otros servicios |
--pids-limit 64 | Una bomba fork llega a 64 y se para |
--cpus 0.5 | Un bucle infinito se queda con medio núcleo |
--read-only | No se puede escribir nada en el sistema de archivos del contenedor |
--tmpfs /tmp:size=16m | Salvo un área pequeña de trabajo, limitada y en memoria |
--cap-drop=ALL | Sin privilegios de kernel — nada de montar, ni sockets crudos, nada |
--security-opt no-new-privileges | Nada de dentro puede ganar más privilegios de los que tenía |
Ejecútalo, y falla antes incluso de arrancar el contenedor:
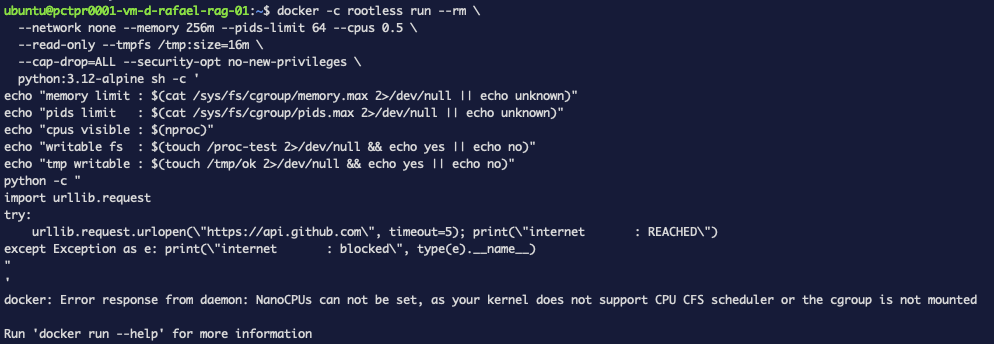
docker: Error response from daemon: NanoCPUs can not be set, as your kernel does not
support CPU CFS scheduler or the cgroup is not mounted
Retén ese mensaje, porque induce a error. El kernel soporta límites de CPU perfectamente — este host ejecuta otros 20 contenedores con ellos disponibles. Volveremos a qué está mal de verdad.
Quita --cpus y todo lo demás se aplica:
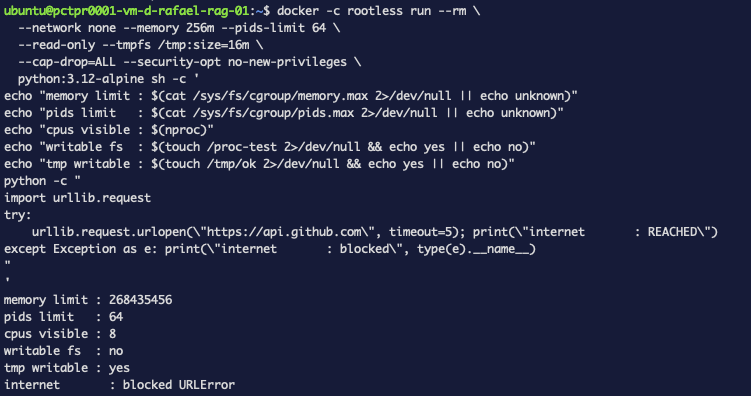
memory limit : 268435456        <- exactamente 256 MiB
pids limit   : 64
cpus visible : 8
writable fs  : no
tmp writable : yes
internet     : blocked URLError
Cinco de seis controles funcionando. Y cpus visible: 8, porque no nos dejaron poner uno.
Demostrar que el hueco es real
Un límite de CPU que falta suena leve al lado de "memoria sin límite". No lo es, porque un bucle infinito es lo más probable que hace el código generado sin querer.
Esto lanza ocho bucles ocupados dentro del sandbox por lo demás completamente cerrado, durante ocho segundos:
docker -c rootless run -d --name burn \
  --network none --memory 256m --pids-limit 64 \
  --read-only --tmpfs /tmp:size=16m \
  --cap-drop=ALL --security-opt no-new-privileges \
  python:3.12-alpine sh -c 'for i in $(seq 8); do (while :; do :; done) & done; sleep 8'
sleep 3
docker -c rootless stats --no-stream burn
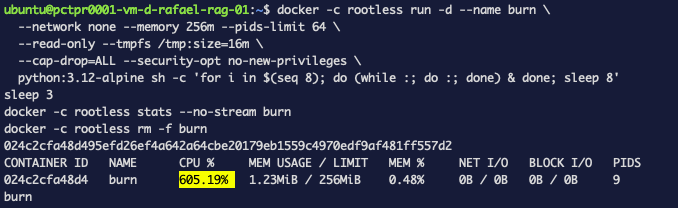
NAME   CPU %     MEM USAGE / LIMIT   NET I/O   PIDS
burn   605.19%   1.23MiB / 256MiB    0B / 0B   9
605% de una CPU. Seis de los ocho núcleos del host, tomados por código dentro de un sandbox donde la memoria está limitada a 256 MB (usó 1,23), los procesos a 64 (usó 9) y la red está completamente bloqueada.
Todos los controles que pusimos funcionan. El único que no pudimos poner es el que se está abusando.
Qué está mal de verdad
El mensaje de error culpaba al kernel. El kernel está bien. La respuesta real es un archivo.
Cuando Docker corre en modo rootless no gestiona recursos directamente: solo puede usar lo que el sistema le haya entregado a tu cuenta de usuario. En Linux moderno esa entrega se llama delegación de cgroups, y quien decide qué se delega es systemd.
cat /sys/fs/cgroup/user.slice/user-1000.slice/cgroup.controllers
memory pids
Dos cosas. Esa es la explicación entera:
El demonio lo sabía desde el principio. Lo dijo al arrancar, diez veces, en líneas que nadie lee:
journalctl --user -u docker.service | grep -i "no .* support"
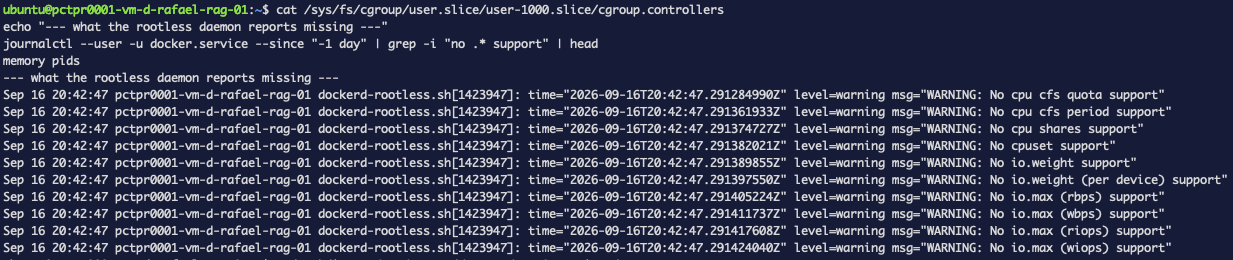
WARNING: No cpu cfs quota support
WARNING: No cpu cfs period support
WARNING: No cpu shares support
WARNING: No cpuset support
WARNING: No io.weight support
WARNING: No io.max (rbps) support
...
Esto también explica algo que la Parte 8 reportó como una limitación sin más del modo rootless: que los límites de rendimiento de disco no funcionan. Misma causa. No es una propiedad de rootless, sino de lo que systemd delegó.
Dónde está documentado
No en la documentación rootless de Docker. Busqué en la página: cero apariciones de "delegate". La guía está río arriba, en el sitio de rootless containers, que lo dice directamente:
By default, a non-root user can only get memory controller and pids controller to be delegated.
El arreglo
Un archivo drop-in que le dice a systemd que entregue más:
sudo mkdir -p /etc/systemd/system/user@.service.d
cat <<EOF | sudo tee /etc/systemd/system/user@.service.d/delegate.conf
[Service]
Delegate=cpu cpuset io memory pids
EOF
sudo systemctl daemon-reload
La misma página advierte:
After changing the systemd configuration, you need to re-login or reboot the host. Rebooting the host is recommended.
Con systemd 249 resultó no hacer falta. Solo con daemon-reload:
cat /sys/fs/cgroup/user.slice/user-1000.slice/cgroup.controllers
cpuset cpu io memory pids
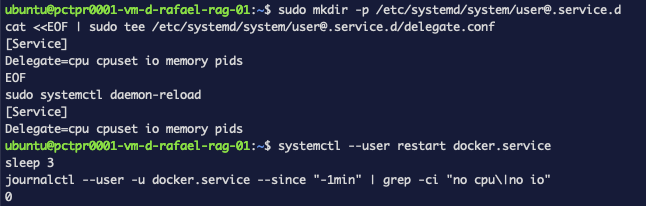
El demonio sí hay que reiniciarlo, porque lee sus capacidades una sola vez al arrancar. Reinicia solo el demonio rootless, no toda tu sesión de usuario, que en este host habría tumbado además un servicio sin relación:
systemctl --user restart docker.service
journalctl --user -u docker.service --since "-1min" | grep -ci "no cpu\|no io"
0
Cero advertencias, donde había diez.
Los mismos ocho bucles, otra vez
Comando idéntico al anterior. Una flag añadida:
docker -c rootless run -d --name burn2 \
  --network none --memory 256m --pids-limit 64 --cpus 0.5 \
  --read-only --tmpfs /tmp:size=16m \
  --cap-drop=ALL --security-opt no-new-privileges \
  python:3.12-alpine sh -c 'for i in $(seq 8); do (while :; do :; done) & done; sleep 8'
sleep 3
docker -c rootless stats --no-stream burn2
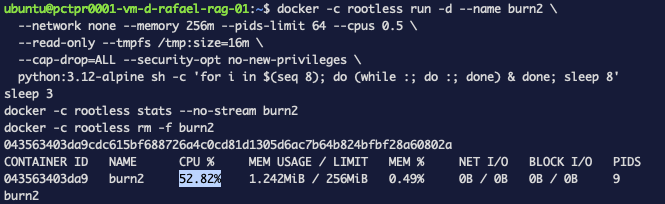
NAME    CPU %    MEM USAGE / LIMIT    NET I/O   PIDS
burn2   52.82%   1.242MiB / 256MiB    0B / 0B   9
605,19% → 52,82%. Los mismos ocho bucles infinitos, la misma imagen, todo igual. Medio núcleo, como se pidió.
Qué deberías llevarte de esto
Un contenedor no es un sandbox hasta que dices qué puede usar. El valor por defecto es generoso en todas las dimensiones que importan, y nada te avisa, porque un contenedor sin restricciones es algo completamente normal de ejecutar.
Comprueba que tus límites se aplican, en lugar de darlo por hecho. Todo este post existe
porque una flag que estaba silenciosamente no disponible se veía idéntica a una flag que
funcionaba. docker stats bajo una carga deliberada tarda un minuto y te dice la verdad.
Los mensajes de error apuntan a la capa equivocada. "your kernel does not support CPU CFS scheduler" describía un kernel que lo soporta perfectamente. La causa real era un valor por defecto de systemd, dos capas más allá, documentado en otra web.
Y el límite honesto: este sandbox contiene recursos. No vuelve seguro el código. No sabe distinguir un script útil de uno hostil, y un programa que haga algo dañino dentro de 256 MB, medio núcleo y sin red se ejecutará exactamente como está escrito. La contención te compra un radio de daño, no un criterio.