El proyecto final: construye, evalúa y observa un asistente de documentación RAG en la API de WEC

 +
Todo en esta serie apuntaba a esto. Sabes demostrar que un modelo funciona (parte 1), hacer su salida fiable para máquinas (parte 2), generar datos de prueba reales (parte 3) y observar producción (parte 4). Ahora gastamos las cuatro habilidades a la vez en el patrón que está detrás de casi todo producto LLM serio: RAG — generación aumentada por recuperación.
Vamos a construir un asistente de documentación: un servicio HTTP en contenedor que responde preguntas de clientes desde la propia documentación de WEC. No un notebook — un servicio, Docker primero, con la forma que realmente desplegarías. Y como esta serie no hace demos del camino felíz: por el camino nuestro RAG alucina un precio de GPU, encontramos la causa en nuestro propio scraper, la arreglamos y fijamos el arreglo con un test de regresión. Cada comando, número y error de abajo viene de una ejecución real.
Lo que vamos a construir
Una decisión de arquitectura por delante: repartimos el trabajo. Los embeddings corren localmente (un modelo ONNX pequeño — rápido, gratis, sin GPU) y la generación corre en WEC. Este es un reparto de producción completamente estándar: la recuperación es barata y sensible a la latencia, así que mantenerla junto a tu almacén de vectores ahorra una ida y vuelta de red por consulta — mientras la generación es donde el modelo grande se gana el sueldo.
El catálogo de WEC ahora incluye bge-m3 (1024 dimensiones, multilingüe, entrada por lotes) en
/v1/embeddings:
curl -s https://inference.wiline.com/v1/embeddings \
  -H "Authorization: Bearer $WEC_API_KEY" -H "Content-Type: application/json" \
  -d '{"model":"bge-m3","input":["first chunk","second chunk"]}' | jq '.data | length'
Pasar este tutorial a esa vía es un cambio de dos funciones — reemplaza las llamadas a fastembed
en ingest.py y main.py por el mismo cliente de OpenAI apuntando a /v1/embeddings
(wec.embeddings.create(model="bge-m3", input=chunks)), y vuelve a ingerir (la dimensión del vector
cambia de 384 a 1024, así que borra y reconstruye la colección). Mantenemos la vía local abajo
porque es gratis, funciona sin conexión, y cada número de esta guía se midió con ella — pero las dos
son legítimas en producción; elige según tu latencia y tus preferencias de operación.
Requisitos previos
- Docker + Compose en una instancia WEC (sirve el mismo entorno que la máquina de Langfuse de la parte 4).
- Una clave de la API de Inferencia de WEC (Inference → API Keys).
- Tu instancia de Langfuse de la parte 4 y sus claves (opcional pero recomendado — se usa en el trazado del Paso 3).
- ~1 GB de disco libre para la imagen. Compruébalo primero:
df -h /. Nuestra máquina estaba al 99% y sobrevivió, pero el disco justo es el asesino silencioso número uno de las builds de Docker.
Paso 1 — Montar el servicio, Docker primero
Las funciones RAG reales se despliegan como servicios, así que empezamos como uno: una app de
FastAPI en un contenedor, con el código montado para que uvicorn --reload recoja cada edición —
sin rebuild por cambio.
mkdir -p ~/rag-service/app && cd ~/rag-service
cat > requirements.txt <<'EOF'
fastapi==0.115.6
uvicorn==0.34.0
chromadb==0.5.23
fastembed==0.4.2
openai==1.59.7
langfuse
requests==2.32.3
beautifulsoup4==4.12.3
EOF
cat > Dockerfile <<'EOF'
FROM python:3.12-slim
WORKDIR /srv
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app/ app/
EXPOSE 8000
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8000", "--reload"]
EOF
cat > docker-compose.yml <<'EOF'
services:
  rag-api:
    build: .
    ports:
      - "8000:8000"
    volumes:
      - ./app:/srv/app          # live code - edit on host, uvicorn reloads
      - chroma-data:/data       # persisted vector index
      - model-cache:/root/.cache # embedding model cache (survives rebuilds)
    environment:
      ANONYMIZED_TELEMETRY: "False"
      WEC_API_KEY: ${WEC_API_KEY}
      LANGFUSE_PUBLIC_KEY: ${LANGFUSE_PUBLIC_KEY}
      LANGFUSE_SECRET_KEY: ${LANGFUSE_SECRET_KEY}
      LANGFUSE_HOST: ${LANGFUSE_HOST}
volumes:
  chroma-data:
  model-cache:
EOF
Los secretos viven en un archivo .env junto al compose (compose lo carga automáticamente — las
claves nunca entran en el YAML). Mantenlo fuera del control de versiones desde el principio:
cat > .env <<'EOF'
WEC_API_KEY=sk-your-wec-key
LANGFUSE_PUBLIC_KEY=pk-lf-…
LANGFUSE_SECRET_KEY=sk-lf-…
LANGFUSE_HOST=http://<your-langfuse-host>:3000
EOF
echo ".env" >> .gitignore
Una app mínima para que el contenedor tenga algo que servir:
cat > app/main.py <<'EOF'
from fastapi import FastAPI

app = FastAPI(title="WEC docs RAG")

@app.get("/health")
def health():
    return {"status": "ok"}
EOF
docker compose up -d --build
curl -s localhost:8000/health
{"status":"ok"}
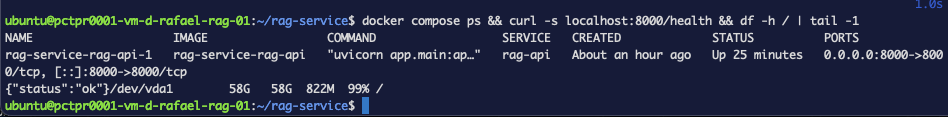 Figura 1. Un comando cada uno: el contenedor arriba,
/health respondiendo, y la comprobación
de disco (la nuestra marca 99% — esta máquina vive peligrosamente). La build tarda unos 90s y son
unos 700 MB de imagen.
Paso 2 — Ingesta: construir el corpus desde un sitio web vivo
En el mundo real, la base de conocimiento de la que quieres que responda tu asistente normalmente no es una carpeta ordenada de markdown — es un sitio web vivo: documentación de producto, un wiki, un centro de ayuda. Así que la habilidad de adquisición de corpus que vale la pena aprender es scraping real, no cargar archivos.
Para este tutorial extraemos el propio sitio de documentación de WEC. Está hecho con Docusaurus,
y Docusaurus (como la mayoría de generadores de sitios) publica un sitemap.xml — lo que significa
que puedes descubrir cada página programáticamente en vez de adivinar URLs. El mismo enfoque
funciona en cualquier sitio que publique un sitemap:
curl -s https://wec.wiline.com/docs/sitemap.xml | grep -c "<loc>" # 109 URLs on the whole site
Filtramos a la documentación de producto (/docs/cloud_portal/), traemos cada página, y nos
quedamos solo con el elemento <article> — Docusaurus envuelve el contenido real en él, así que la
navegación, la barra lateral y el pie nunca llegan al índice:
cat > app/ingest.py <<'EOF'
"""Scrape the WEC docs site -> chunk -> embed locally -> Chroma."""
import re, requests, chromadb
from bs4 import BeautifulSoup
from fastembed import TextEmbedding

SITEMAP = "https://wec.wiline.com/docs/sitemap.xml"
FILTER  = "/docs/cloud_portal/"          # product docs only
CHUNK, OVERLAP = 700, 100                # chars

def discover():
    xml = requests.get(SITEMAP, timeout=30).text
    urls = re.findall(r"<loc>([^<]+)</loc>", xml)
    return [u for u in urls if FILTER in u]

def scrape(url):
    html = requests.get(url, timeout=30).text
    art = BeautifulSoup(html, "html.parser").find("article")  # Docusaurus main content
    return art.get_text("\n", strip=True) if art else ""

def chunk(text):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i + CHUNK])
        i += CHUNK - OVERLAP
    return out

if __name__ == "__main__":
    urls = discover()
    print(f"sitemap -> {len(urls)} product-doc pages")

    docs, metas = [], []
    for u in urls:
        for c in chunk(scrape(u)):
            docs.append(c)
            metas.append({"url": u})
    print(f"scraped -> {len(docs)} chunks")

    embedder = TextEmbedding("BAAI/bge-small-en-v1.5")   # local, ~66MB ONNX, no GPU needed
    vectors = [v.tolist() for v in embedder.embed(docs)]
    print(f"embedded -> {len(vectors)} vectors (dim {len(vectors[0])})")

    db = chromadb.PersistentClient(path="/data")
    col = db.get_or_create_collection("wec-docs")
    col.add(ids=[str(i) for i in range(len(docs))],
            documents=docs, metadatas=metas, embeddings=vectors)
    print(f"indexed -> collection 'wec-docs' now has {col.count()} chunks")
EOF
docker compose exec rag-api python -m app.ingest
sitemap -> 37 product-doc pages
scraped -> 281 chunks
model_optimized.onnx: 100%|████████████| 66.5M/66.5M [00:03<00:00, 16.9MB/s]
embedded -> 281 vectors (dim 384)
indexed -> collection 'wec-docs' now has 281 chunks
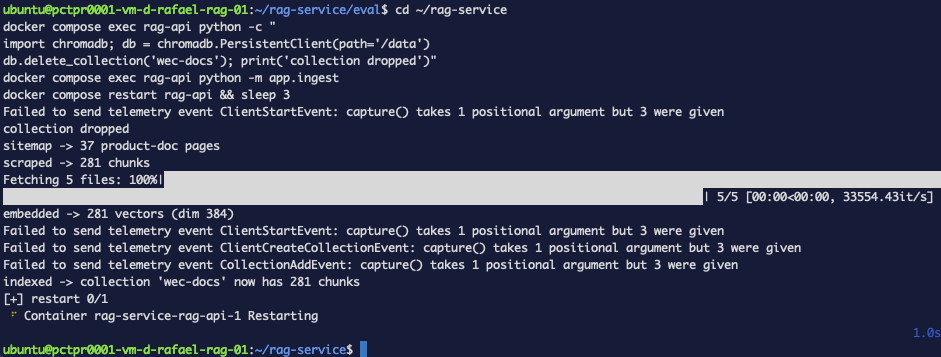 Figura 2. Todo el corpus de documentación de producto indexado en menos de un minuto. El modelo
de embeddings se guarda en caché en el volumen
model-cache, así que se descarga exactamente una
vez.
Sabes convertir cualquier sitio web de documentación en un índice vectorial consultable — descubrimiento por sitemap, extracción de contenido, troceado, embeddings locales.
get_text("\n", …)Nuestra primera versión usaba get_text(" ") — un solo espacio como separador. Parecía inofensivo y
causó una alucinación auténtica que verás en el Paso 4. Conserva el salto de línea; volveremos a
esto. (¿Quieres ver el bug ocurrir en tu propia máquina? Cambia "\n" de vuelta a " " en
scrape(), vuelve a ejecutar la ingesta, y haz la pregunta del Paso 4 — luego devuelve el salto de
línea y vuelve a ingerir.)
Puedes ver Failed to send telemetry event ClientStartEvent: capture() takes 1 positional argument… — un choque conocido de versiones entre chromadb y posthog. Es inofensivo (tus datos
están bien), y la variable ANONYMIZED_TELEMETRY: "False" del compose lo silencia.
Paso 3 — El endpoint /ask: recuperar, generar, trazar
Ahora el servicio en sí. Tres decisiones de diseño que vale la pena declarar:
- Las citas vienen de los metadatos de recuperación, no del modelo. El modelo puede alucinar
URLs; el almacén de vectores no.
sourceses determinista. - La llamada a WEC pasa por
langfuse.openai(el reemplazo directo de la parte 4), y cada etapa recibe un span con@observe— así que cada petición produce un árbolask → retrieve → generateen Langfuse. timeout=60en el cliente. La lección de la parte 4: sin timeout por defecto, un backend atascado cuelga tu servicio en silencio.
cat > app/main.py <<'EOF'
import os, chromadb
from fastapi import FastAPI
from pydantic import BaseModel
from fastembed import TextEmbedding
from langfuse import observe, get_client
from langfuse.openai import openai          # auto-traces the WEC call

app = FastAPI(title="WEC docs RAG")

db = chromadb.PersistentClient(path="/data")
col = db.get_or_create_collection("wec-docs")
embedder = TextEmbedding("BAAI/bge-small-en-v1.5")

wec = openai.OpenAI(
    base_url="https://inference.wiline.com/v1",
    api_key=os.environ["WEC_API_KEY"],
    timeout=60,
)

class Ask(BaseModel):
    question: str

@observe()                                   # span: retrieve
def retrieve(question: str, k: int = 4):
    qv = list(embedder.embed([question]))[0].tolist()
    res = col.query(query_embeddings=[qv], n_results=k)
    chunks = res["documents"][0]
    sources = sorted({m["url"] for m in res["metadatas"][0]})
    return chunks, sources

@observe()                                   # span: generate (WEC call nested inside)
def generate(question: str, chunks: list[str]) -> str:
    context = "\n---\n".join(chunks)
    resp = wec.chat.completions.create(
        model="Qwen2.5-3B-Instruct",     # small on purpose: cheap + fast per query,
                                         # and its failures teach (see Step 5)
        name="rag-generate",
        messages=[{"role": "user", "content":
            "Answer the question using ONLY the context below. "
            "If the context doesn't contain the answer, say so. "
            "When quoting a price or number, copy it VERBATIM with its unit and the item "
            "it belongs to; never combine numbers from different lines and never compute "
            "new numbers from examples.\n\n"
            f"Context:\n{context}\n\nQuestion: {question}"}],
    )
    return resp.choices[0].message.content

@app.post("/ask")
@observe()                                   # root span: the whole request
def ask(body: Ask):
    chunks, sources = retrieve(body.question)
    answer = generate(body.question, chunks)
    get_client().flush()
    return {"answer": answer, "sources": sources}

@app.get("/health")
def health():
    return {"status": "ok"}
EOF
docker compose up -d --build
Hazle una pregunta real de cliente:
curl -s localhost:8000/ask -H "Content-Type: application/json" \
  -d '{"question": "How do I create an API key for the Inference API?"}' | python3 -m json.tool
{
    "answer": "To create an API key for the Inference API, follow these steps:\n1. Log in to the WiLine Edge Cloud.\n2. Expand the \"Inference\" section in the left sidebar.\n3. Click on the \"API Keys\" tab.\n4. Click the \"+ Create Key\" button located above the keys table. ...",
    "sources": [
        "https://wec.wiline.com/docs/cloud_portal/platform/inference/api/wiline-edge-cloud-inference-api/",
        "https://wec.wiline.com/docs/cloud_portal/platform/inference/api_keys/",
        "https://wec.wiline.com/docs/cloud_portal/platform/inference/examples/",
        "https://wec.wiline.com/docs/cloud_portal/platform/inference/models_hub/",
        "https://wec.wiline.com/docs/cloud_portal/platform/inference/overview/"
    ]
}
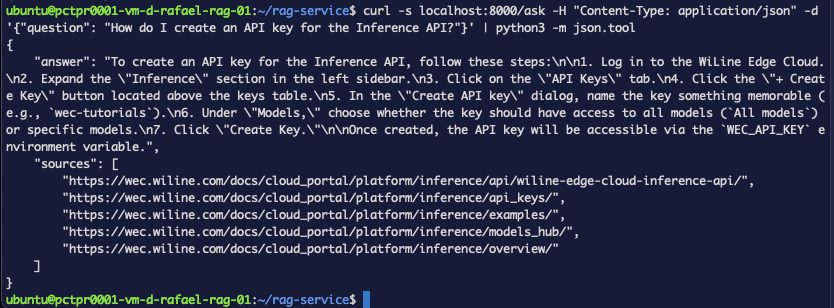 Figura 3. Al primer intento: el flujo exacto de la clave de API sacado de la documentación, con
la página correcta citada. Extraer → embeddings → recuperar → generar, de punta a punta.
Abre Langfuse → Tracing y encontrarás la petición como un árbol de spans — ask → retrieve → generate → rag-generate — con latencia y tokens por paso. Cuando una respuesta es mala, así
distingues mala recuperación de mala generación (la habilidad de la parte 4, ahora en una app
real).
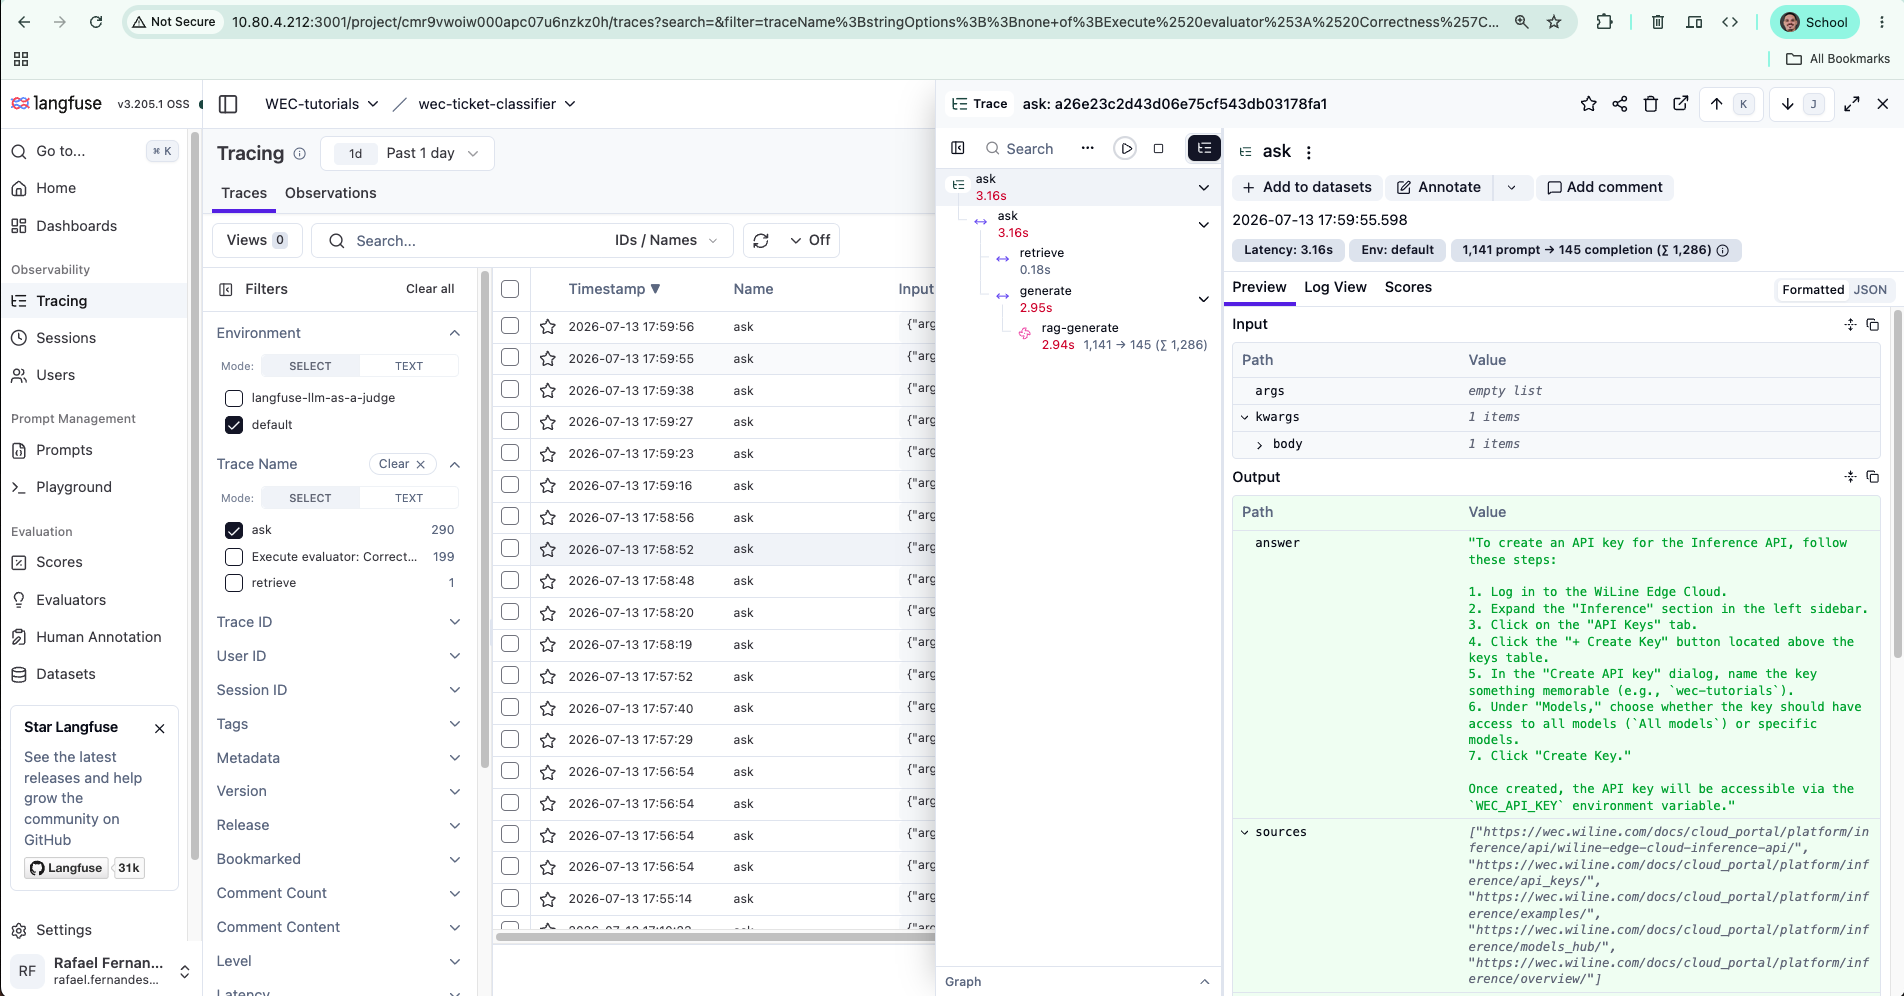 Figura 4. Cada
/ask se convierte en un árbol: la recuperación y la generación tienen cada una
su dirección.
Tienes un servicio RAG trazado y en contenedor respondiendo desde documentación extraída en vivo.
Paso 4 — La alucinación que cazamos (de verdad)
Un buen RAG tiene que negarse a lo que la documentación no cubre. Pínchalo:
curl -s localhost:8000/ask -H "Content-Type: application/json" \
  -d '{"question": "Does WEC offer a free GPU tier for students?"}' | python3 -m json.tool
Nuestra primera versión (la del scraper con get_text(" ")) respondió:
"No, WEC does not offer a free GPU tier specifically for students. The pricing for
GPU hourly is listed as $0.66/GPU-hr with a 25% off annual prepay option at
$0.10/GB-mo for block storage. There is no mention of a free GPU tier in the
provided information."
La negativa es correcta. Pero vuelve a leer la frase del precio: "$0.66/GPU-hr con una opción de prepago anual con 25% de descuento a $0.10/GB-mo para almacenamiento en bloque" — son tres hechos distintos soldados en una sola afirmación falsa, pegando una tarifa de almacenamiento a la opción de prepago de GPU. Consulta la página real de precios y descubres que simplemente son tres elementos adyacentes:
- GPU por hora: $0.66/GPU-hr
- Prepago anual: 25% de descuento
- Almacenamiento en bloque: $0.10/GB-mo
El modelo cosió un precio de almacenamiento a "GPU". ¿Por qué? Mira el trozo que le dimos. Nuestra extracción separada por espacios había aplastado las tarjetas de precios en una única línea indiferenciada:
... $1.44 /mo Starting at $0.66 /GPU-hr GPU hourly 25 % off Annual prepay $0.10 /GB-mo Block storage ...
La alucinación la fabricó nuestra propia ingesta. El modelo confundió precios porque destruimos la estructura antes de generar los embeddings. Este es el fallo RAG más clásico que existe — basura entra, basura sale — y solo lo cazas pinchando con preguntas y leyendo los trozos recuperados.
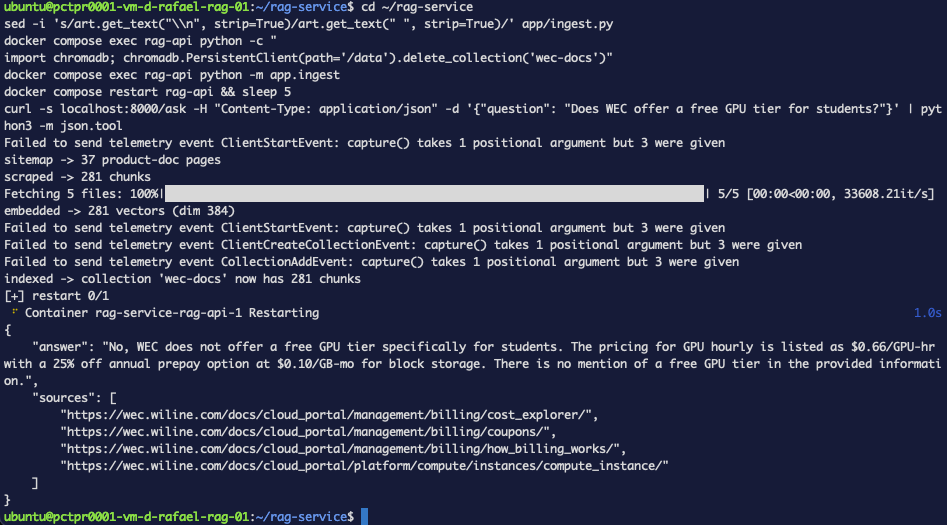 Figura 5. El bug en libertad: negativa correcta, precios revueltos — una tarifa de
almacenamiento pegada a la opción de prepago de GPU. Las fuentes parecen perfectamente plausibles.
Por esto "cita fuentes" no es lo mismo que "está fundamentado".
Dos arreglos, los dos ya en el código de arriba:
- Extracción consciente de la estructura —
get_text("\n", strip=True)conserva los límites de línea, así que las tarjetas de precio siguen siendo líneas separadas en vez de una sopa. - Un prompt de generación endurecido — cita los números literalmente con su unidad y su elemento; nunca combines líneas; nunca derives números nuevos de ejemplos. (Antes de esta regla, el modelo calculaba alegremente un falso "$1.5834/GPU-hour" a partir de un ejemplo de gasto diario.)
Después de volver a ingerir con el arreglo, la confusión con el precio de almacenamiento desaparece. Queda ambigüedad residual — la tira de precios todavía contiene fragmentos como "$1.44/mo" (un precio de instancia de cómputo) cerca de la línea de GPU, y arreglar eso de verdad necesita extracción consciente de tablas (mira Lo que viene). Que es exactamente la razón por la que existe el paso siguiente: fijar el bug arreglado para que no pueda volver en silencio.
Paso 5 — Evaluar el servicio como una puerta de CI
Este paso necesitó cuatro rondas de arreglos para conseguir un número honesto — y el viaje del 39% al 87% es la mejor lección de la serie, porque casi nada de lo que arreglamos por el camino era el RAG en sí.
Reutilizamos la habilidad de la parte 3 — generar un conjunto de QA desde el propio corpus — y
calificamos el endpoint HTTP vivo con Promptfoo. La primera versión del generador pedía una
pregunta por página con un key_fact que la respuesta debía contener, y devolvió 37/37 pares.
Algunas etiquetas ya olían mal — un vago "All paid", rutas de menú en vez de respuestas — pero
vamos a ejecutarlo de forma naíf primero y dejar que los fallos nos enseñen. Convierte a un conjunto
de datos de Promptfoo con aserciones de subcadena simples (icontains: + el hecho clave) y apúntalo
al servicio en marcha. El proveedor es HTTP — calificamos la API real, exactamente lo que haría
una puerta de CI:
mkdir -p eval
{ echo 'question,__expected'; jq -r '[.question, ("icontains:" + .key_fact)] | @csv' app/qa.jsonl; } > eval/tests.csv
cat > eval/promptfooconfig.yaml <<'EOF'
description: "RAG service eval — QA set generated from the scraped docs + regression"
providers:
  - id: https
    config:
      url: http://localhost:8000/ask
      method: POST
      headers:
        Content-Type: application/json
      body:
        question: "{{question}}"
      transformResponse: json.answer
tests:
  - file://tests.csv
  # regression: the storage-price-as-GPU-price conflation from Step 4
  - vars:
      question: "What is the pricing model for GPU hourly usage in Edge Cloud?"
    assert:
      - type: not-icontains
        value: "0.10"
      - type: not-icontains
        value: "GB-mo"
EOF
cd eval && npx -y promptfoo@latest eval -c promptfooconfig.yaml --no-cache
Results:
  ✓ 15 passed (39.47%)
  ✗ 23 failed (60.53%)
Duration: 40s (concurrency: 4)
Ese 39,5% es lo que medimos durante el desarrollo, con el bug del Paso 4 todavía vivo. Vuelve a ejecutar la misma eval naíf contra el servicio terminado y sale mucho más alto — 27/38:
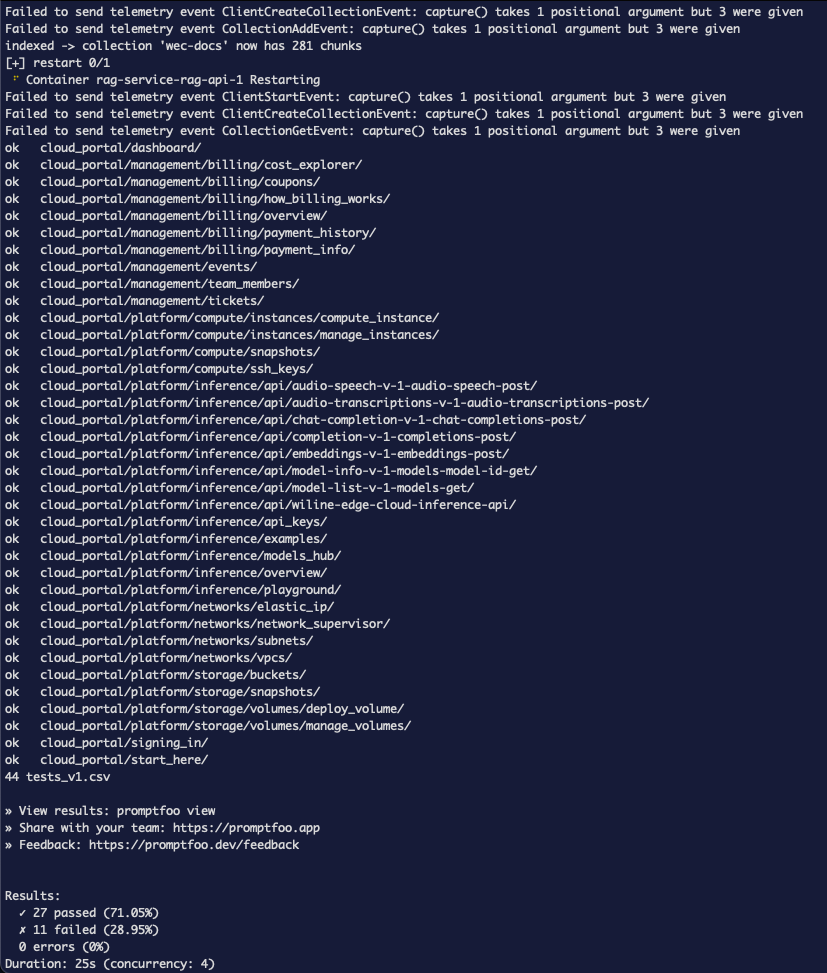 Figura 6. La misma eval naíf contra el servicio terminado: 71,05%. Mejor servicio, las mismas
etiquetas ruidosas — la diferencia de 30 puntos entre estas dos ejecuciones es toda calidad del
servicio, y los dos números significan poco hasta que lees las filas.
Lee los fallos antes de entrar en pánico. De los 23 fallos de la ejecución de desarrollo, la mayoría no son fallos del RAG:
| Fallo | Qué pasó en realidad |
|---|---|
| Respuesta de "Balance due": "the amount that remains due… $0.00" | Respuesta correcta; la etiqueta exigía la frase All paid — etiqueta mala |
| Payment Information: da la ruta de menú exacta y correcta | Correcto; la redacción de la etiqueta no coincide como subcadena — aserción frágil |
| Precio de GPU: "$0.10 per GB-month" | Fallo real — la confusión del Paso 4, reproduciéndose sistemáticamente |
| Formato por defecto de TTS: "not specified in the context" | Fallo real de recuperación — el trozo con el valor por defecto no se recuperó |
Mejora 1 — un juez en vez de subcadenas. Apenas ayuda.
La coincidencia de subcadenas (icontains) era perfecta para el único campo JSON de la parte 2 y es
demasiado frágil para respuestas RAG largas. La mejora obvia es la habilidad de la parte 4: un
juez LLM calificando la consistencia semántica (aserciones llm-rubric: + un modelo juez en
defaultTest). Hicimos exactamente eso — las mismas 37 etiquetas, juez en vez de subcadenas — y
obtuvimos:
Results:
  ✓ 17 passed (44.74%)
  ✗ 21 failed (55.26%)
Duration: 8m 21s (concurrency: 4)
39,5% → 44,7%. Apenas se movió — porque el juez hace cumplir fielmente unas etiquetas malas.
Las filas con key_fact basura siguen fallando: la referencia está mal, no la respuesta. Un
calificador mejor no puede rescatar un conjunto de datos malo. El cuello de botella nunca fue el
tipo de aserción.
Mejora 2 — curar las etiquetas con una puerta
Así que arregla los datos (la disciplina de la parte 3, ahora impuesta por código). El generador v2
exige que la etiqueta sea la respuesta — no una ruta de menú, no un nombre de sección — y añade una
puerta de curación: el key_fact tiene que existir literalmente en el texto de origen, o la
fila se rechaza en el sitio:
cat > app/gen_qa.py <<'EOF'
"""Generate a QA eval set from the indexed docs — v2, curated labels."""
import os, json, chromadb
from openai import OpenAI

wec = OpenAI(base_url="https://inference.wiline.com/v1",
             api_key=os.environ["WEC_API_KEY"], timeout=60)

db = chromadb.PersistentClient(path="/data")
col = db.get_or_create_collection("wec-docs")
data = col.get(include=["documents", "metadatas"])

pages = {}
for doc, meta in zip(data["documents"], data["metadatas"]):
    pages.setdefault(meta["url"], []).append(doc)

kept, skipped = 0, 0
with open("/srv/app/qa.jsonl", "w") as f:
    for url, chunks in sorted(pages.items()):
        ctx = "\n".join(chunks[:2])[:2000]
        resp = wec.chat.completions.create(
            model="Qwen2.5-3B-Instruct", temperature=0.3,
            messages=[{"role": "user", "content":
                "From this documentation excerpt, write ONE question a customer would ask, "
                "and the fact that ANSWERS it. Return ONLY JSON with keys:\n"
                "question (string), key_fact (string).\n"
                "Rules for key_fact: it must be THE ANSWER to the question (not a menu path, "
                "not a section name), a short phrase copied VERBATIM from the excerpt, "
                "max 8 words.\n\n"
                f"Excerpt:\n{ctx}"}],
        )
        raw = resp.choices[0].message.content
        try:
            start, end = raw.index("{"), raw.rindex("}") + 1
            row = json.loads(raw[start:end])
            # curation gate: the label must literally exist in the source text
            if row["key_fact"].lower().strip() not in ctx.lower():
                print(f"SKIP {url.split('/docs/')[1]}: key_fact not verbatim in source")
                skipped += 1
                continue
            row["url"] = url
            f.write(json.dumps(row) + "\n")
            kept += 1
            print(f"ok   {url.split('/docs/')[1]}: {row['question'][:50]} -> {row['key_fact'][:40]}")
        except Exception as e:
            print(f"SKIP {url}: {e}")
            skipped += 1
print(f"done -> {kept} kept, {skipped} rejected by curation gate")
EOF
docker compose exec rag-api python -m app.gen_qa
ok   cloud_portal/management/billing/how_billing_works/: What is the starting point ... -> How Billing Works
SKIP cloud_portal/management/billing/overview/: key_fact not verbatim in source
ok   cloud_portal/platform/inference/api/wiline-edge-cloud-inference-api/: What is the base URL ... -> https://inference.wiline.com/v1
SKIP cloud_portal/platform/inference/api_keys/: key_fact not verbatim in source
...
done -> 15 kept, 22 rejected by curation gate
15 conservados, 22 rechazados. Esa tasa de rechazo es el punto: más de la mitad de lo que produjo el generador habría calificado el RAG contra referencias equivocadas. Un conjunto de datos más pequeño y fiable vence a uno más grande y envenenado.
El generador muestrea con temperatura 0.3, así que el recuento exacto cambia ligeramente entre ejecuciones — aquí una regeneración posterior que conservó 16 de 37; la tasa de rechazo sigue siendo brutal en cualquier caso:
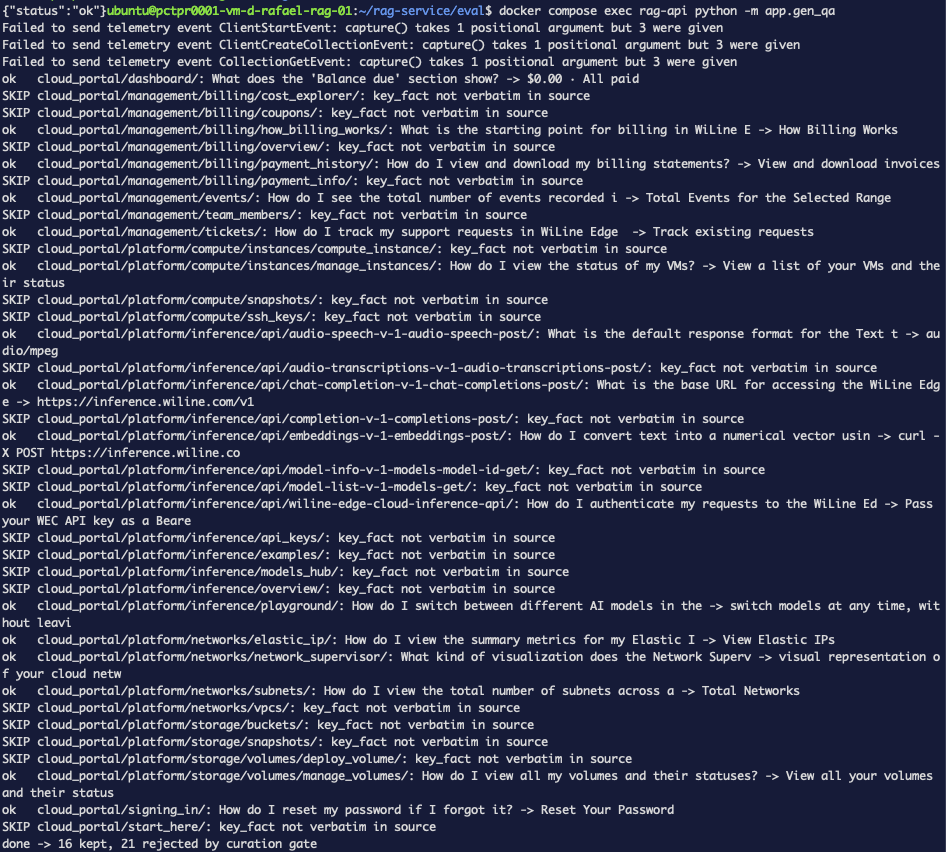 Figura 7. La puerta en acción: 16 conservados, 21 rechazados en esta ejecución. Cada etiqueta
que sobrevive está demostrablemente en la documentación — hechos-respuesta reales como
audio/mpeg y
la URL base de la API, no rutas de menú. (Las ejecuciones documentadas abajo usan nuestro primer
conjunto curado: 15 pares + la regresión = 16 tests.)
Reconstruye tests.csv con una rúbrica que le dé al juez la pregunta y la referencia verificada,
más reglas explícitas de PASS/FAIL (una redacción distinta está bien; una contradicción falla):
{ echo 'question,__expected'; jq -r '[.question, ("llm-rubric:Question asked: \"" + .question + "\". Reference fact from the official docs: \"" + .key_fact + "\". PASS if the answer correctly addresses the question and does not contradict the reference fact — different wording is fine. FAIL only if the answer is wrong, contradicts the reference, or fails to answer the question.")] | @csv' ../app/qa.jsonl; } > tests.csv
Results:
  ✓ 12 passed (75.00%)
  ✗ 4 failed (25.00%)
Duration: 2m 47s (concurrency: 4)
75%. Mejor — pero antes de celebrarlo, lee los cuatro fallos. Y aquí el hábito de la serie paga una vez más, porque tres de ellos tampoco eran fallos del RAG.
Mejora 3 — el juez mismo estaba rompiéndose
Los tres fallos cuya razón de calificación era solo "No output" compartían dos señales:
graderError: true, y una completación de exactamente 1024 tokens — el max_tokens por defecto
de Promptfoo. Nuestro juez es un modelo que razona: gastó todo el presupuesto razonando y quedó
cortado antes de emitir el JSON del veredicto, que Promptfoo cuenta como FAIL. El cuarto "fallo"
sí obtuvo un veredicto — pero el juez pequeño había repetido literalmente el marcador del esquema
(reason: "string") en vez de calificar. Las dos respuestas eran de hecho correctas.
Dos líneas de configuración lo arreglan — un juez más grande, y espacio para pensar:
defaultTest:
  options:
    provider:
      id: openai:chat:Qwen3.5-122B
      config:
        apiBaseUrl: https://inference.wiline.com/v1
        apiKeyEnvar: WEC_API_KEY
        temperature: 0
        # thinking models spend tokens on reasoning before the verdict JSON;
        # the 1024 default silently truncated the judge and failed 3 tests
        max_tokens: 4096
Results:
  ✓ 14 passed (87.50%)
  ✗ 2 failed (12.50%)
Y la fila que más importa:
│ What is the pricing model for GPU hourly usage in Edge Cloud? │ [PASS] ... starting at $0.66/GPU-hour. │
La regresión está en verde — la confusión del Paso 4 está fijada y no puede volver en silencio.
(Una nota cosmética: el juez de 122B a veces reduce su texto de razón a un lacónico ... — los
veredictos en sí son correctos, que es lo que lee la puerta.)
Sabes poner una puerta de CI a un servicio RAG vivo: QA generado y curado por una puerta, un juez para la semántica, regresiones deterministas para bugs conocidos — y sabes depurar al propio juez.
Mejora 4 — el 87,5% no sobrevivió a una repetición
Un hábito que esta serie machaca: vuelve a ejecutar antes de creer. Lo hicimos — y obtuvimos
75%, con filas distintas fallando que antes. Facturación, que acababa de pasar, ahora falló
con un eco circular; la respuesta de TTS decía "mp3" en una ejecución y "sin especificar" en la
siguiente. La puntuación era una lotería porque el servicio mismo era no determinista:
generate() no pasaba temperature, así que cada eval calificaba una tirada distinta de dados con
el valor por defecto de 1.0.
Una línea acaba con la lotería — añádela a la llamada a create() en generate():
temperature=0, # determinism: same question -> same answer
Vuelve a ejecutar dos veces. 13/16 — 81,25% — las dos veces, con los mismos tres fallos. El número bajó y eso es la victoria: el 87,5% era en parte suerte (las filas inestables cayeron bien en esa ejecución); el 81,25% es reproducible. Alguien que repita tu eval debería obtener tu número.
Los tres fallos reales — por fin, bugs de RAG de verdad
Después de cuatro rondas arreglando la medición, lo que queda es señal — estable entre ejecuciones, y cada uno es un tipo clásico de fallo RAG distinto:
- Subredes ("Total Networks") — fallo de recuperación, límite de trozo. La página correcta
aparece en el ranking, pero si vuelcas los cuatro trozos recuperados ninguno contiene el bloque de
estadísticas con la respuesta; el trozo de arriba empieza a mitad de palabra
(
"iated with subnets\nData Transfer…"). El troceado de tamaño fijo por caracteres partió el hecho por un límite, y la mitad con la respuesta no aparece en el ranking. Clase de arreglo: más solapamiento,kmayor, o troceado consciente de la estructura. - Formato por defecto de TTS — fallo de recuperación, el hecho no está en el top-k. El trozo que declara el valor por defecto nunca llega al contexto. Detalle revelador: con temperatura 1.0 esta fila a veces pasaba — el modelo adivinaba "mp3" sin evidencia. El determinismo convirtió una adivinanza afortunada en un fallo honesto y consistente.
- Facturación ("How Billing Works") — calidad de generación. A temperatura 0 el modelo pequeño repite deterministamente la frase de origen — "This is the starting point for billing…" — sin nombrar la página. Recuperación correcta sin negativa, respuesta circular e inútil; el juez la falla con razón. Clase de arreglo: trabajo de prompt ("nombra la página o sección que estás citando") o un modelo de generación más fuerte.
Gasta la señal — un parámetro, elegido por la eval
Una eval fiable no es la meta; es el mapa. Acaba de decirnos que dos de tres fallos son de la misma
clase — hechos que no llegan a los cuatro trozos recuperados. El arreglo más barato de esa clase es
un carácter, en retrieve():
def retrieve(question: str, k: int = 6): # was 4 — two misses said "not enough context"
Vuelve a ejecutar. Y luego otra vez, porque ya es el hábito:
Results:
  ✓ 14 passed (87.50%)
  ✗ 2 failed (12.50%)
14/16 — 87,5% — dos veces, los mismos dos fallos. Lee qué pasó con cada uno:
- TTS por defecto — arreglado. Con seis trozos la página que declara el valor por defecto llega al contexto, y el servicio ahora responde "mp3" con evidencia, en cada ejecución — la adivinanza afortunada se convirtió en una respuesta fundamentada.
- Subredes — sobrevivió. Incluso con
k=6el trozo con el bloque de estadísticas no aparece en el ranking: este fallo es semántico, no de presupuesto — el texto destrozado por el límite ("iated with subnets…") genera embeddings pobres. Máskno puede arreglar lo que el troceado rompió; este necesita de verdad troceado consciente de la estructura. - Facturación — sobrevivió, como estaba previsto. Es un fallo de calidad de generación; ningún parámetro de recuperación iba a tocarlo nunca.
El número vuelve a 87,5% — el mismo que la ejecución afortunada — pero esta vez se reproduce, y cada punto tiene una explicación.
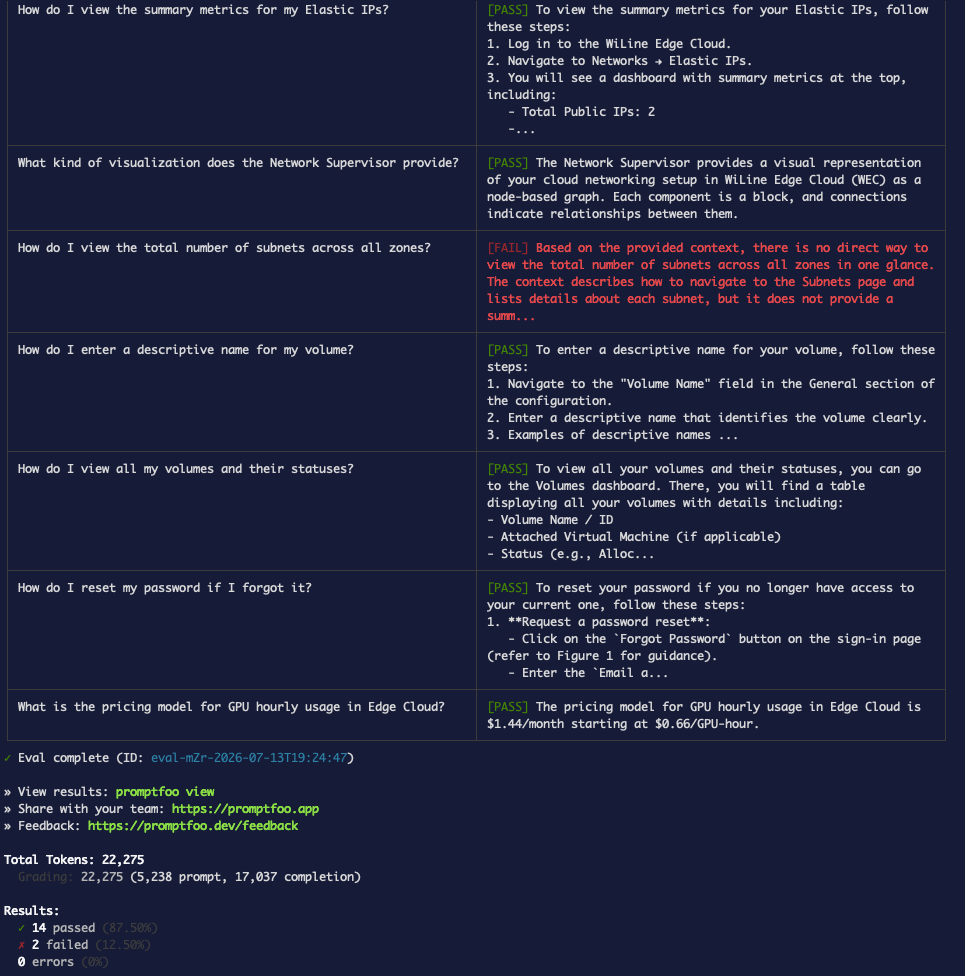 Figura 8. La ejecución final: 14/16, los mismos dos fallos cada vez, regresión en PASS.
Lee el número final con honestidad
39,5% → 44,7% → 75% → 87,5% (con suerte) → 81,25% (honesto) → 87,5% (ganado). Hasta el último paso, el RAG apenas cambió — lo que cambió fue la medición: las aserciones (subcadenas → juez), las etiquetas (puerta de curación), la configuración del propio juez (truncamiento), el determinismo (temperatura). Solo entonces un parámetro de recuperación, elegido por la eval, movió la calidad de verdad. Esa es la última lección de la serie:
- La mayoría de los "fallos" eran nuestra eval mintiéndonos — etiquetas malas, aserciones frágiles, un juez truncado en silencio, un servicio tirando dados. Lee las filas antes de tocar el RAG.
- El número honesto era más bajo que el afortunado — y vale más, porque se reproduce. Si tu puntuación cambia cuando repites, todavía no tienes una puntuación.
- Arregla la medición primero, luego gasta su señal. El mismo 87,5% aparece dos veces en este arco; solo el segundo significa algo — sobrevive a las repeticiones y cada punto tiene una explicación.
- La puntuación es un instrumento de tendencia; las filas son la verdad. El 87,5% todavía no es "la calidad del RAG" — es este conjunto de datos, este juez, este corpus. Fija lo que nunca debe regresar con aserciones deterministas; deja que el juez siga el resto.
Lo que has construido
- Un servicio RAG con Docker primero: extraer (sitemap → extracción del artículo) → trocear →
embeddings locales (fastembed/ONNX) → Chroma → generación en WEC, detrás de
POST /askcon citas deterministas. - Una historia de bug real: pinchamos el caso negativo, cazamos un precio de GPU revuelto (una tarifa de almacenamiento soldada a la opción de prepago de GPU), encontramos la causa en la estructura aplastada del scraper, arreglamos la ingesta y endurecimos el prompt, y lo fijamos con un test de regresión que ahora pasa.
- Una eval con forma de CI del endpoint vivo: QA curado por una puerta (15 pares verificados literalmente de 37 generados) + un juez que depuraste como cualquier otro componente — 39,5% → 87,5% reproducible, arreglando primero la medición (aserciones, etiquetas, configuración del juez, determinismo) y luego gastando su señal en un parámetro de recuperación elegido por la eval. Quedan dos fallos reales y nombrables — a propósito, con sus clases de arreglo nombradas.
- Observabilidad completa: cada petición un árbol de spans en Langfuse — recuperación y generación depurables por separado.
Las partes 1 a 4 eran la caja de herramientas. Esto es para lo que sirve la caja de herramientas.
Resolución de problemas
/ask no devuelve nada después de reindexar
Si borras y recreas la colección de Chroma mientras la API está en marcha, el servicio conserva un handle obsoleto de la colección y cada consulta lanza:
chromadb.errors.InvalidCollectionException: Collection 9b486740-… does not exist.
El proceso en marcha guardó en caché el UUID de la colección antigua. Reinicia el servicio
(docker compose restart rag-api) — o resuelve la colección por petición en vez de al arrancar.
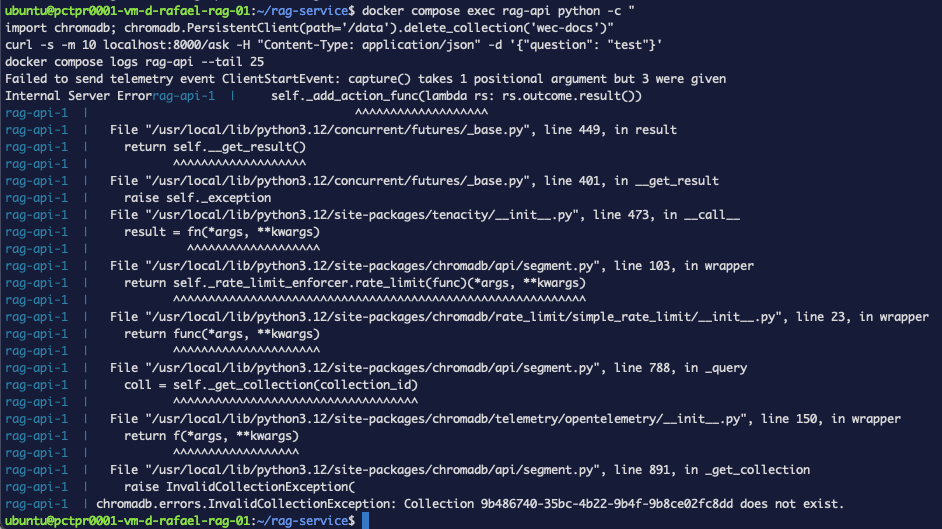 Figura 9. Reindexar invalida los handles abiertos — una trampa clásica de producción del tipo
"funciona hasta que reconstruyes el índice".
Failed to send telemetry event … capture() takes 1 positional argument
Choque inofensivo de versiones entre chromadb y posthog. Pon ANONYMIZED_TELEMETRY: "False" en el
entorno (ya está en nuestro compose).
Fallos del juez con razón "No output" (y graderError: true)
Comprueba los tokens de completación del registro de calificación: si son exactamente 1024 — el
max_tokens por defecto de Promptfoo — tu juez con razonamiento gastó todo el presupuesto razonando
y quedó cortado antes del JSON del veredicto. Pon max_tokens: 4096 en el proveedor del juez. Señal
relacionada: un juez pequeño devolviendo reason: "string" está repitiendo el marcador del esquema
en vez de calificar — usa un juez más grande.
La eval con juez es lenta o los veredictos parecen aleatorios
Los jueces con razonamiento son lentos (~minutos para una docena de filas) e imperfectos — espera cambios de veredicto ocasionales entre ejecuciones. Mantén aserciones deterministas para bugs conocidos (son gratis y nunca cambian) y trata la puntuación del juez como una tendencia, no como una verdad. Si una fila del juez se cuelga del todo, normalmente es un hipo transitorio de red y no tu configuración — reintenta antes de depurar.
La build de Docker falla con "no space left on device"
La imagen necesita ~1 GB (chromadb y onnxruntime son las capas pesadas). Comprueba df -h / primero
y docker system df para ver espacio reclamable — pero nunca hagas prune a ciegas en una máquina
compartida: "reclamable" miente cuando hay contenedores de otros proyectos en marcha.
Lo que viene
Las limitaciones honestas son la hoja de ruta, y cada una viene de un fallo que viste ocurrir:
troceado consciente de la estructura (el fallo de subredes sobrevivió a k=6 — el trozo
destrozado por el límite genera embeddings pobres, así que ningún presupuesto de recuperación lo
rescata), trabajo de prompt o de modelo en la generación (el eco de facturación: obliga al
modelo a nombrar la página que cita, o usa un generador más fuerte), extracción consciente de
tablas (la tira de precios sigue siendo sopa de fragmentos — la regresión pasa, pero "$1.44/mo"
todavía se filtra cerca de la línea de GPU; añade una aserción positiva para la cifra correcta, no
solo not-icontains para las equivocadas), y calibración del juez (califica al juez contra un
puñado de veredictos humanos). Cada una mueve la tasa de aprobados por una razón que puedes nombrar
— que, después de cinco partes, es el punto entero: no adivinas si tu IA funciona. La mides, la
observas, y la haces demostrarlo.