Limita la salida de un contenedor de agente para que solo alcance una API y nada más

- 1Lock down Docker networks
- 2Run containers as non-root
- 3Identity in front of every port
- 4Membership, not just an account
- 5An identity for the agent, not a key
- 6A tool server that checks who is asking
- 7Where the agent can go, not just what it can call
- 8Move the daemon off root
- 9Run the model's own code without trusting it
- 🏆A scope per tool, and a refusal clients can act on
La parte 4 de orquestación de agentes dividió una caja de herramientas para que el agente de agenda no pudiera emitir reembolsos. La parte 5 le dio al agente una identidad propia en el gateway. La parte 6 puso un verificador de JWT delante del servidor de herramientas para que rechace a quien llama sin identificarse.
Todas ellas controlan qué puede llamar el agente. Ninguna controla adónde puede ir.
Esa distinción es todo este artículo. La exfiltración no necesita una herramienta. Necesita un socket.
Una WEC Instance: 8 vCPU AMD EPYC 7601, 15 GB de RAM, Ubuntu 22.04, kernel 5.15. Docker
29.1.3 con backend de firewall iptables — que en esta distribución es iptables-nft
v1.8.7, una capa que en realidad escribe en nftables. El contenedor de pruebas es
alpine:3.20. UFW está activo.
Cada código de estado, cada mensaje de error y cada medición de este artículo salen de la ejecución descrita. HTTP plano en una LAN privada donde aparece la LAN, como en toda la serie.
Dos direcciones, y solo una suele estar vigilada
Un firewall decide qué paquetes pueden cruzar un límite. Casi siempre la gente lo dice en una sola dirección — entrante: quién desde fuera puede llegar hasta tu servicio. Eso es lo que hace publicar un puerto, y de eso trataba la parte 1 de esta serie.
La salida es la otra dirección: adónde puede llegar tu servicio. A qué direcciones puede abrir una conexión y a cuáles no.
Casi nadie configura la salida, y para una aplicación web normal es una decisión razonable. Habla con su base de datos y con un proveedor de pagos, hace lo que dice su código, y ese código no cambia entre despliegues.
Un agente no es eso. Un agente decide qué hacer en tiempo de ejecución, a partir de texto que acaba de leer — un correo, un ticket de soporte, una página web, un documento que escribió otra persona. Si un atacante controla ese texto, influye en lo que el agente hace a continuación. Y lo que no quieres que haga a continuación es exfiltración: enviar tus datos a donde no deben ir.
La exfiltración no necesita ninguna herramienta especial. Cualquier proceso que pueda abrir un socket puede enviar cualquier cosa que pueda leer. Por eso la dirección que nadie vigila es justo la que importa aquí.
Lo que dicen realmente los estándares
La referencia principal para este tipo de problema es LLM06:2025 Agencia Excesiva de OWASP. Su sección de prevención enumera, en orden: minimizar las extensiones, minimizar la funcionalidad de las extensiones, evitar extensiones abiertas, y algunos puntos más sobre permisos y aprobación humana.
Lee la página buscando la red y no está. Ni "egress", ni "firewall", ni "red", ni "aislamiento", ni "sandbox" — esas palabras no aparecen en la entrada.
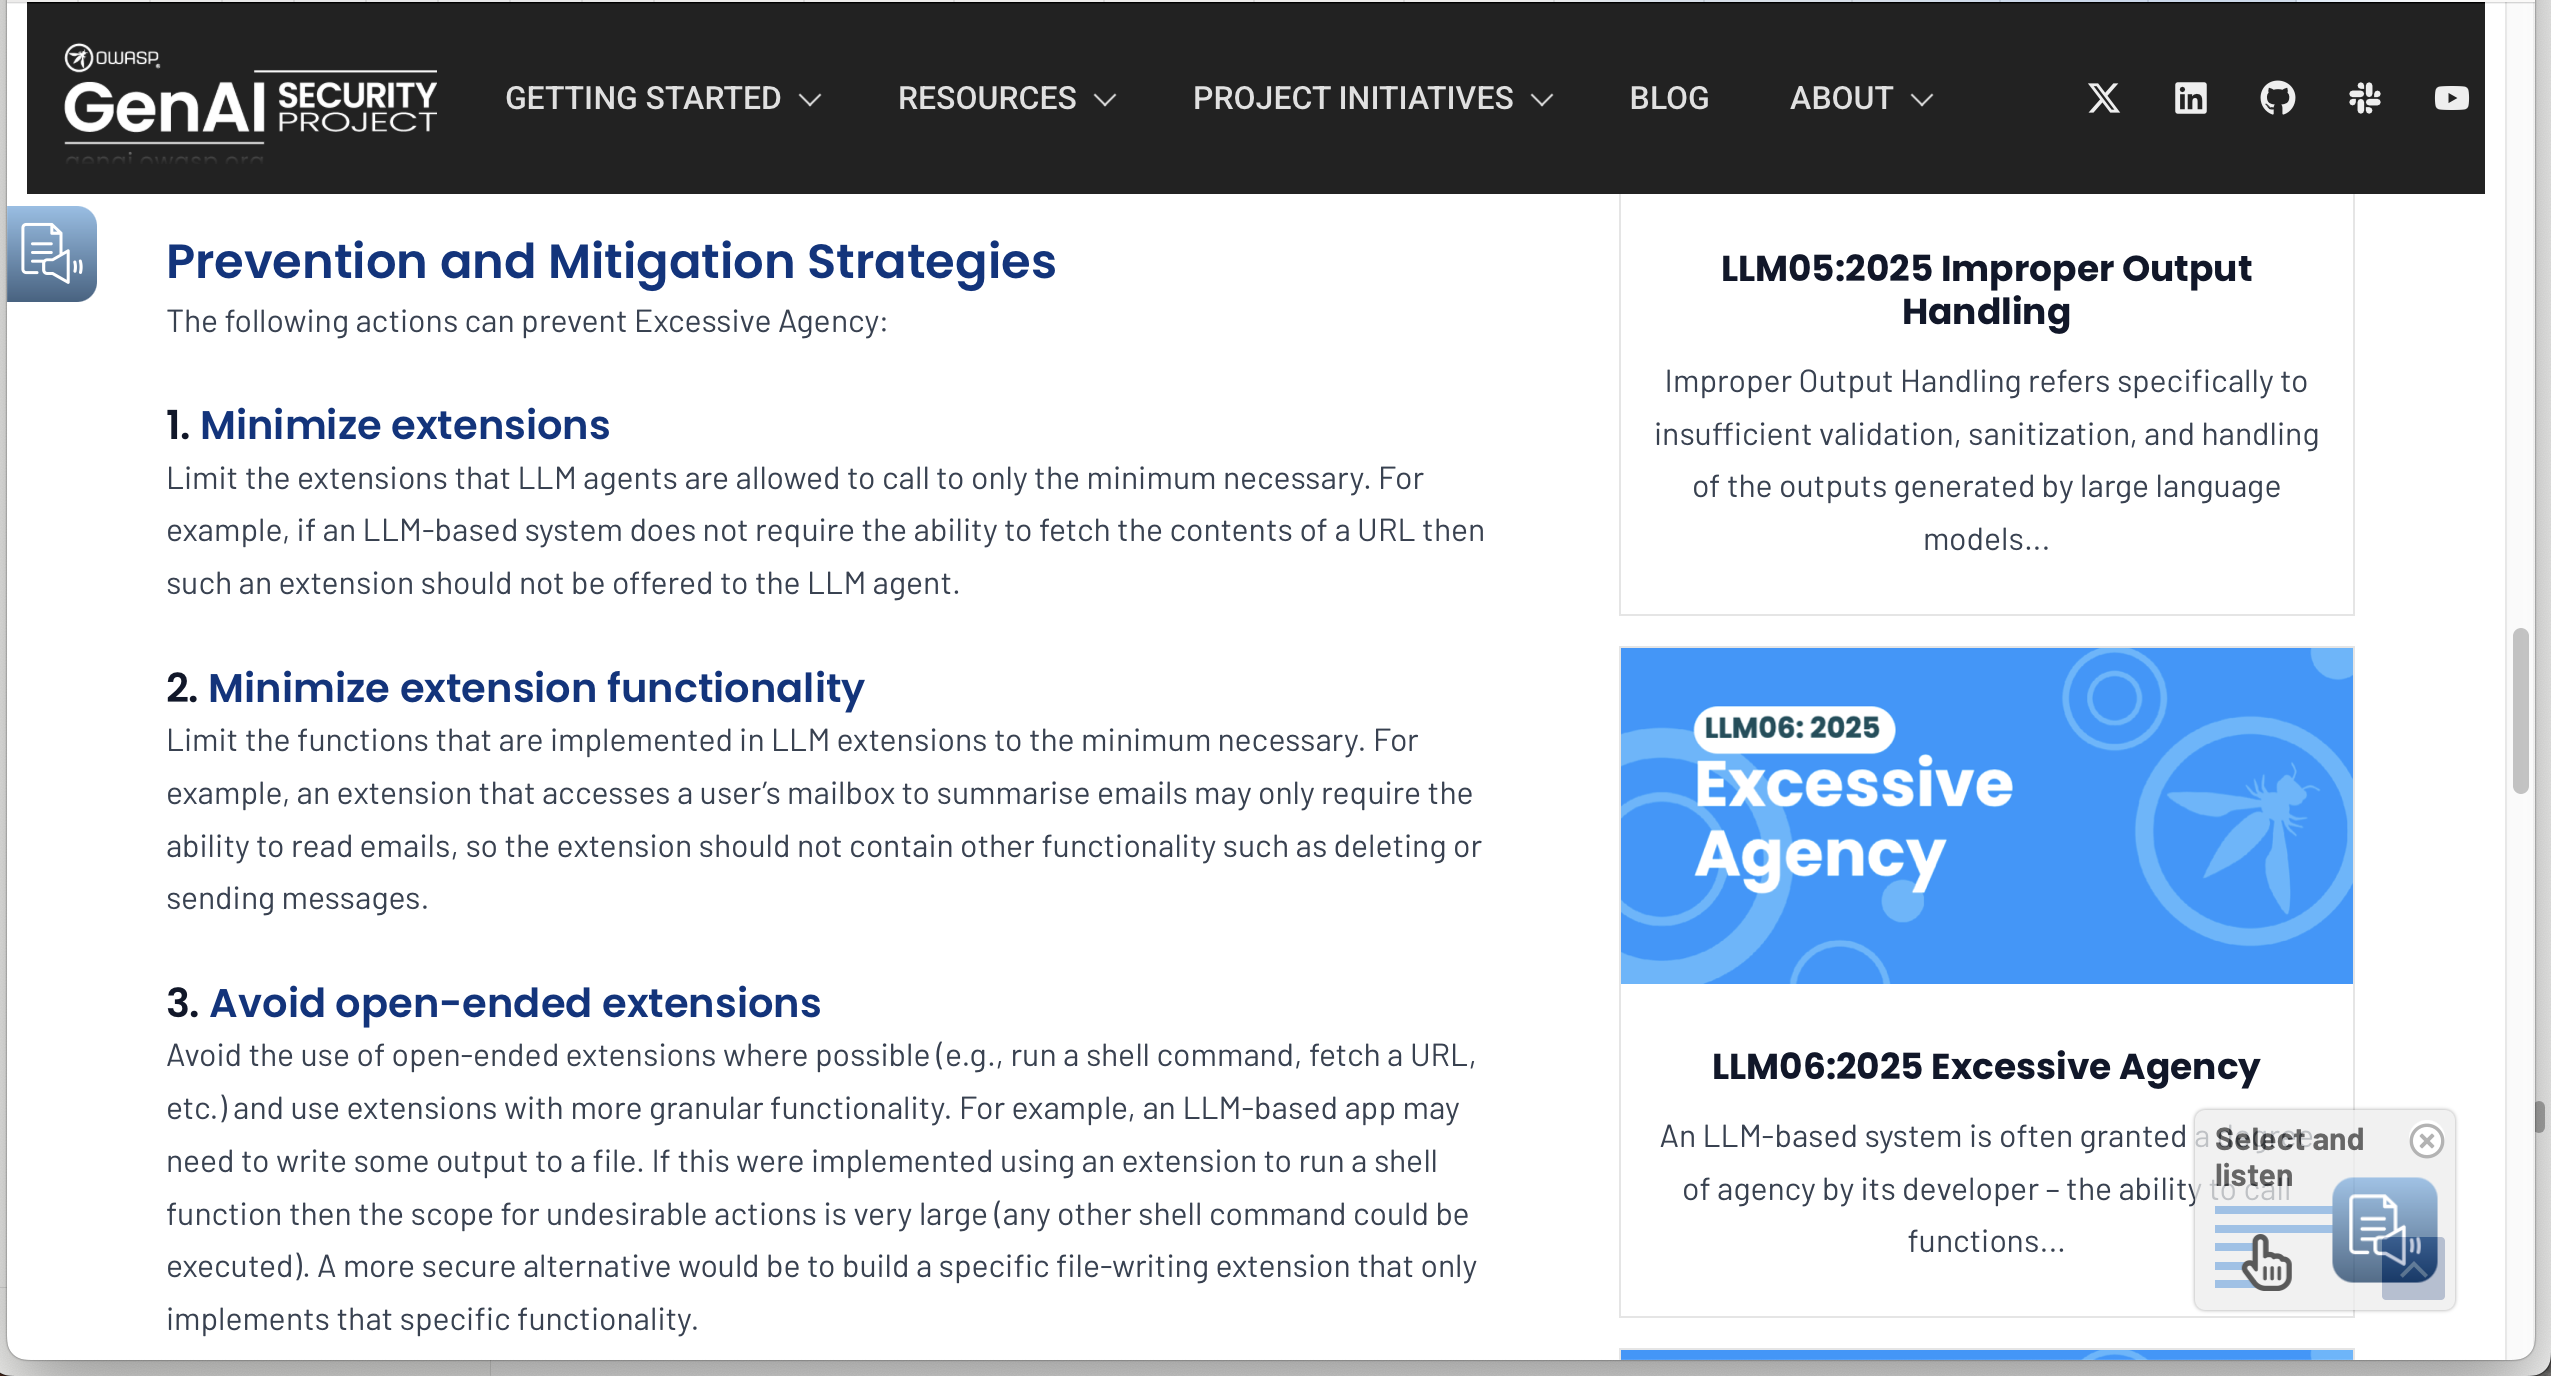
Cada mitigación de esa lista opera sobre herramientas. Quita la extensión, acota la extensión, evita la extensión abierta. Todo es buen consejo. Nada de eso cambia un solo byte de lo que un proceso comprometido puede hacer con un socket TCP.
Hay quien defiende que esto es un hueco y no un descuido, y el argumento se está haciendo dentro del propio repositorio de OWASP. Un issue abierto que propone un mapeo de aplicación en tiempo de ejecución para el Top 10 Agéntico lo dice sin rodeos:
The enforcement pipeline assumes agents cannot reach tools without passing through the proxy. If tools are directly reachable, runtime enforcement collapses.
y concluye que "Network-level controls (e.g., Kubernetes NetworkPolicy, Docker network isolation) are required to close this gap in production."
Fíjate en qué es eso: un issue abierto, presentado por un colaborador, con su mapeo marcado como (Proposed). No es el estándar. Es alguien argumentando que el estándar debería decir esto.
Y la razón por la que esto importa no es teórica. EchoLeak (CVE-2025-32711) es una inyección de prompt indirecta de cero clics contra Microsoft 365 Copilot, registrada en NVD como "Ai command injection in M365 Copilot allows an unauthorized attacker to disclose information over a network." Over a network. La lista de herramientas nunca fue lo que falló.
Requisitos previos
- Docker en Linux con el backend de firewall
iptables— el predeterminado. Compruébalo condocker info | grep -i "Firewall Backend" sudo, y voluntad de escribir reglas de firewall en una máquina que aún puedas alcanzar- Nada de las partes anteriores. Esta se sostiene sola.
DOCKER-USER es estado real del firewall de tu host. Una regla que coincida con más de lo que
pretendías dejará servicios fuera de línea. Todas las reglas de este artículo están acotadas con
-i br-agent, una interfaz que pertenece a una red creada para este fin — que es justo por lo
que en el paso 1 nombramos ese bridge a mano en lugar de dejar que Docker genere uno.
Si trabajas por SSH, ninguna de estas reglas toca la cadena INPUT, así que tu sesión no corre
riesgo. Compruébalo tú mismo antes de creértelo.
Paso 1 — Demuestra el hueco
Una red, con la interfaz del bridge nombrada explícitamente. Docker documenta la opción como "Interface name to use when creating the Linux bridge":
docker network create --driver bridge \
  -o com.docker.network.bridge.name=br-agent agent-egress
ip -br link show br-agent
br-agent DOWN 8a:77:65:54:9b:0d <NO-CARRIER,BROADCAST,MULTICAST,UP>
DOWN, porque todavía no hay nada conectado. Una red de Docker es una interfaz que no se
levanta hasta que se conecta un contenedor, y una regla con -i br-agent sobre una red inactiva
no coincide con nada, en silencio. Conviene saberlo antes de pasar una hora depurando una
política que nunca se ejecutó.
El contenedor de pruebas — con versión fijada, no latest:
docker run -d --name agent-sandbox --network agent-egress alpine:3.20 sleep infinity
docker exec agent-sandbox apk add --no-cache curl bind-tools
Ahora cuatro destinos. Fíjate en lo que no hay en este contenedor: ni agente, ni framework, ni cliente MCP, ni herramientas. Aquí no se está evadiendo el acotado de herramientas — es que no hay nada que evadir.
docker exec agent-sandbox curl -sS -m 8 -o /dev/null -w 'inference API   HTTP %{http_code}\n' https://inference.wiline.com/v1/models
docker exec agent-sandbox curl -sS -m 8 -o /dev/null -w 'arbitrary host  HTTP %{http_code}\n' https://example.com
docker exec agent-sandbox curl -sS -m 8 -o /dev/null -w 'authentik LAN   HTTP %{http_code}\n' http://10.80.4.212:9100/
docker exec agent-sandbox curl -sS -m 8 -o /dev/null -w 'other network   exit=%{exitcode} %{errormsg}\n' http://172.21.0.2:5432/
inference API   HTTP 401
arbitrary host  HTTP 200
authentik LAN   HTTP 302
other network   exit=28 Connection timed out after 5002 milliseconds
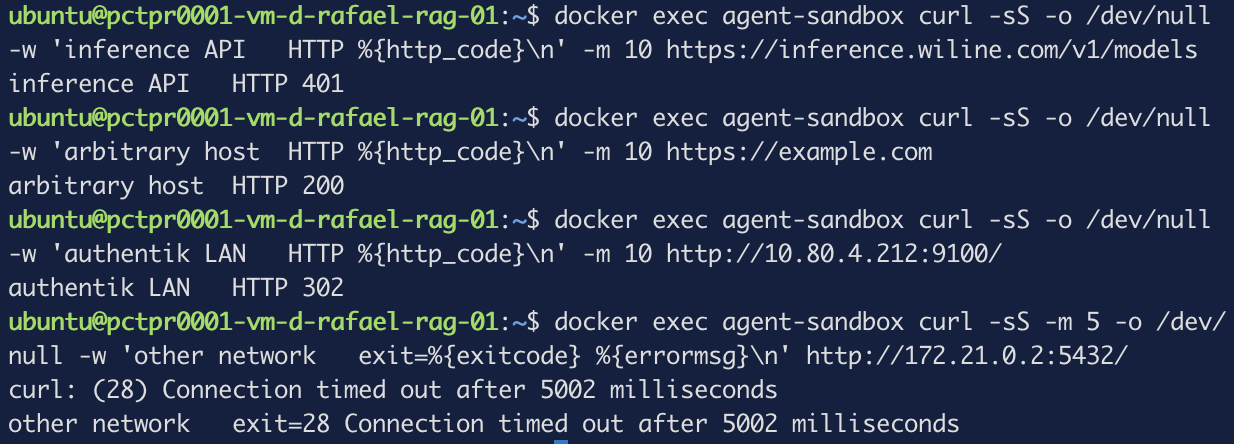
El 401 es el que conviene entender. No se envió ninguna clave de API, así que la petición
nunca llega a nada que pudiera cobrarse — pero un 401 es una respuesta HTTP, lo que significa
que el handshake TCP se completó, que TLS negoció, y que respondió un servidor real.
Alcanzabilidad demostrada, gratis.
La cuarta línea es la que mantiene esto honesto. Ese es un contenedor de Postgres en otra red de Docker, y expira — la parte 1 de esta serie estableció que las redes bridge separadas sí aíslan, y esto lo confirma.
Así que la forma del hueco es precisa, no vaga:
| Destino | Resultado | |
|---|---|---|
| Otra red de Docker | expira | Docker ya se encarga de esto |
| Tu propia LAN, incluido el proveedor de identidad | 302 | abierto |
| Internet abierto | 200 | abierto |
| La única API que de verdad necesita | 401 | abierto |
Docker aísla los contenedores entre sí y ahí se detiene. Las dos direcciones que importan para la exfiltración — tu red e internet — están abiertas de par en par, y ninguna guía de Docker lo presenta como un hueco porque, para una aplicación web, no lo es.
Paso 2 — El suelo
Una regla. Fíjate en -A y no -I: la denegación va al final de la cadena y se queda ahí,
y cada permiso que añadamos después se apila encima. Ese orden es la política.
sudo iptables -A DOCKER-USER -i br-agent -j DROP
DOCKER-USER es donde esto corresponde, y la documentación de Docker dice por qué:
Rules appended to the
FORWARDchain will be processed after Docker's rules.
DOCKER-USER se procesa antes que ellas — la documentación la describe como "a placeholder
for user-defined rules that will be processed before rules in the DOCKER-FORWARD and DOCKER
chains." En cualquier otro sitio, el ACCEPT del propio Docker llega primero.
Léelo de arriba abajo y la colocación se explica sola. DOCKER-FORWARD contiene un ACCEPT
incondicional por cada bridge — eso es lo que hace que la salida de los contenedores funcione, y
por eso una regla añadida a FORWARD nunca se dispara. DOCKER-USER es el único punto que
queda por delante.
Repite las mismas cuatro sondas:
inference API   exit=28 Resolving timed out after 8000 milliseconds
arbitrary host  exit=28 Resolving timed out after 8002 milliseconds
authentik LAN   exit=28 Connection timed out after 8003 milliseconds
other network   exit=28 Connection timed out after 8002 milliseconds
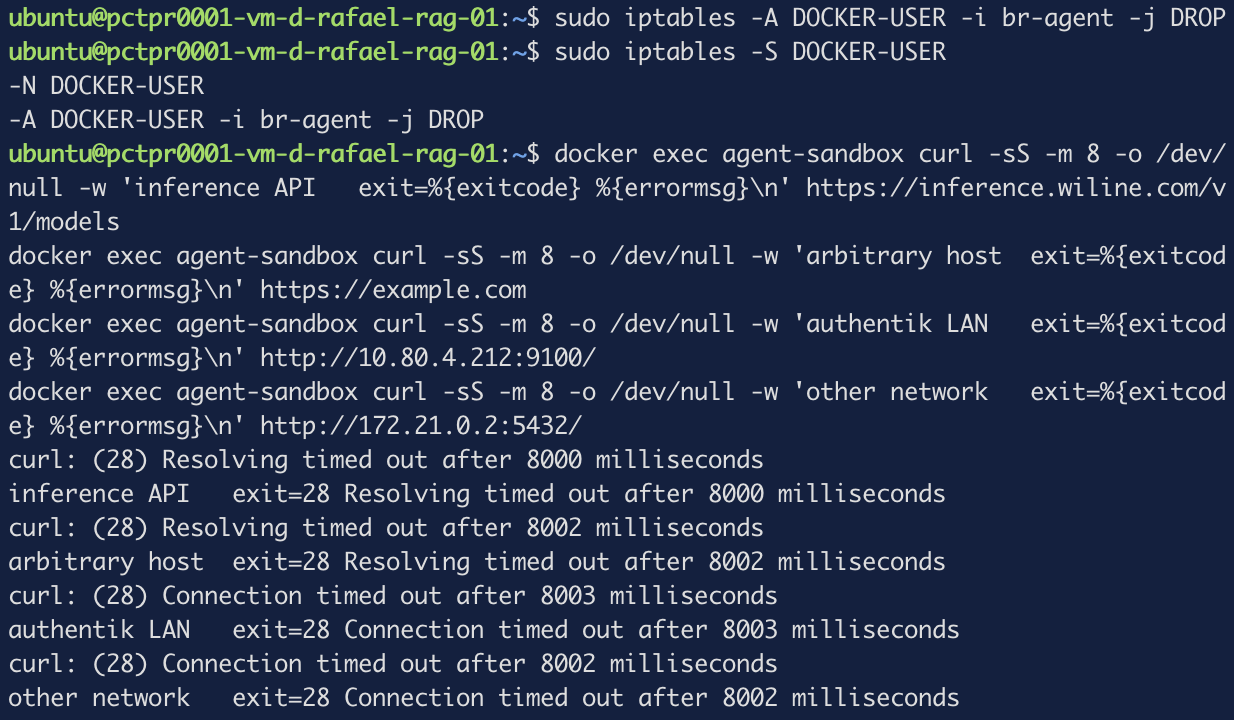
Lee el texto del error, no el fallo. Dos mensajes distintos, y la diferencia es información de diagnóstico gratuita:
- "Resolving timed out" — el propio DNS quedó bloqueado. Nunca llegamos a saber la dirección.
- "Connection timed out" — la dirección ya se conocía, el paquete salió, y el DROP lo cazó.
Las dos sondas por nombre murieron en la resolución; las dos por IP murieron en el socket. Lo
que nos dice algo que no es obvio: el resolvedor integrado de Docker reenvía sus consultas a
través de DOCKER-USER. El resolvedor vive en 127.0.0.11 dentro del espacio de nombres del
contenedor, y es tentador suponer que ese tráfico nunca toca la ruta de forwarding del host. Sí
la toca.
Fíjate también en que cada fallo tardó los ocho segundos completos. Un DROP produce
expiraciones; un REJECT falla al instante. Sigilo contra facilidad de depuración, y este
artículo elige el sigilo — pero si todavía estás iterando sobre una política, REJECT te
ahorrará muchísima espera.
Paso 3 — La lista de permitidos
Antes de escribir una regla para el resolvedor, averigua qué resolvedor usa realmente el contenedor:
docker exec agent-sandbox cat /etc/resolv.conf
nameserver 127.0.0.11
search corp.internal internal mesh.example.com
options edns0 trust-ad ndots:0

# Based on host file: '/etc/resolv.conf' (internal resolver)
# ExtServers: [8.8.8.8 8.8.4.4]
ExtServers: [8.8.8.8 8.8.4.4]. El contenedor no está usando el DNS de esta red. El host
resuelve a través de systemd-resolved en 127.0.0.53, que es una dirección de loopback y por
tanto inútil dentro del espacio de nombres de un contenedor, así que Docker sustituyó el DNS
público de Google sin mencionarlo.
Mira los dominios de búsqueda heredados en el mismo bloque (aquí redactados, pero reales en tu
máquina). Cada nombre interno que ese contenedor resuelve se le está preguntando a 8.8.8.8,
con el sufijo de los dominios privados que heredó del host. Nadie eligió eso, y nada lo saca a
la luz salvo leer este fichero.
También decide la regla: permite el resolvedor que el contenedor tiene, no el que supusiste.
getent hosts inference.wiline.com
67.207.107.229 inference.wiline.com
sudo iptables -I DOCKER-USER -i br-agent -p udp --dport 53 -d 8.8.8.8,8.8.4.4 -j ACCEPT
sudo iptables -I DOCKER-USER -i br-agent -p tcp --dport 53 -d 8.8.8.8,8.8.4.4 -j ACCEPT
sudo iptables -I DOCKER-USER -i br-agent -p tcp --dport 443 -d 67.207.107.229 -j ACCEPT
sudo iptables -S DOCKER-USER
-N DOCKER-USER
-A DOCKER-USER -d 67.207.107.229/32 -i br-agent -p tcp -m tcp --dport 443 -j ACCEPT
-A DOCKER-USER -d 8.8.4.4/32 -i br-agent -p tcp -m tcp --dport 53 -j ACCEPT
-A DOCKER-USER -d 8.8.8.8/32 -i br-agent -p tcp -m tcp --dport 53 -j ACCEPT
-A DOCKER-USER -d 8.8.4.4/32 -i br-agent -p udp -m udp --dport 53 -j ACCEPT
-A DOCKER-USER -d 8.8.8.8/32 -i br-agent -p udp -m udp --dport 53 -j ACCEPT
-A DOCKER-USER -i br-agent -j DROP
Cinco permisos sobre una denegación. Las mismas cuatro sondas, por tercera vez:
inference API   HTTP 401 exit=0
arbitrary host  exit=28 Connection timed out after 8002 milliseconds
authentik LAN   exit=28 Connection timed out after 8003 milliseconds
other network   exit=28 Connection timed out after 8001 milliseconds
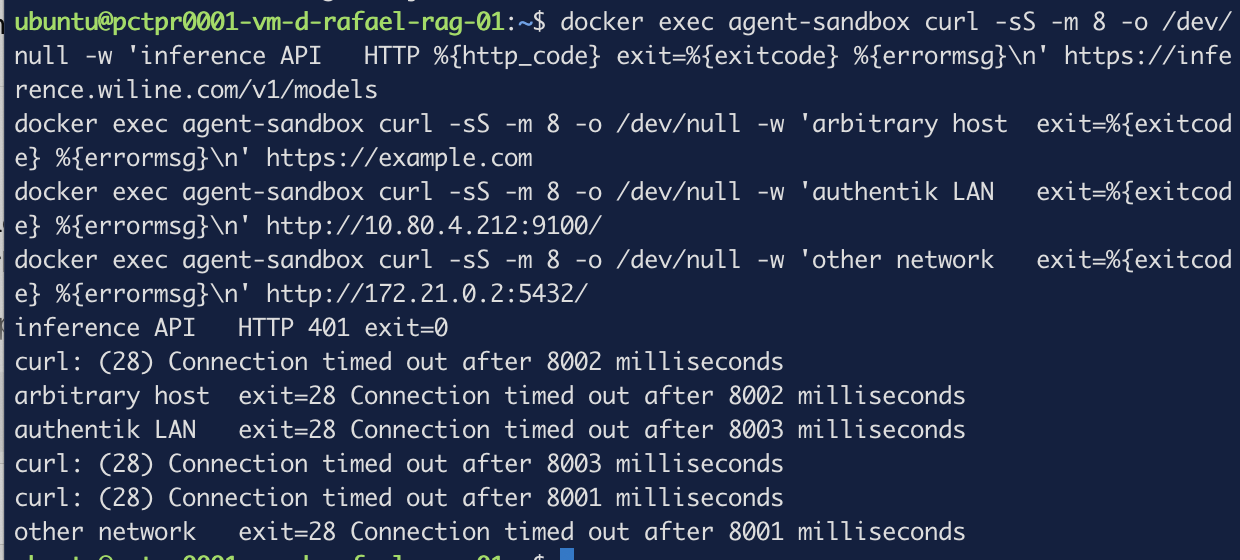
Mira la segunda línea. Dice "Connection timed out", no "Resolving timed out". El DNS está
abierto, así que example.com sí resolvió a una dirección real — y entonces el paquete murió.
La resolución funcionó y el socket no.
Ese es todo el artículo en una línea. Un proceso comprometido dentro de ese contenedor puede averiguar adónde enviar tus datos y no puede enviarlos.
Todas las guías sobre este tema te dicen que primero aceptes el tráfico RELATED,ESTABLISHED, y
la documentación de Docker muestra la regla. Esta política no tiene ninguna, y el 401 de
arriba demuestra que el handshake TLS completo y la respuesta HTTP volvieron igualmente.
La razón es la dirección. Nuestro DROP coincide con -i br-agent — tráfico que llega desde
el contenedor. Los paquetes de vuelta llevan -o br-agent, nunca coinciden, atraviesan
DOCKER-USER sin tocarse, y los aceptan después las propias reglas de seguimiento de conexiones
de Docker.
Necesitas el ACCEPT de conntrack cuando tu DROP puede coincidir con la dirección de vuelta, que
es el caso de los ejemplos de tráfico entrante de donde viene ese consejo. Un DROP de salida
específico de dirección, no. Añádela igualmente si quieres — no cuesta nada — pero entiende que
copiarla sin entenderla es como se llega a la conclusión de que las reglas de firewall son magia
negra.
Paso 4 — Medir el coste, dos veces
Una política que nadie mide es una política que alguien desactivará cuando haya carga. Así que: ¿cuánto cuestan seis reglas?
El enfoque obvio, veinte conexiones con las reglas puestas y veinte sin ellas:
for i in $(seq 20); do docker exec agent-sandbox curl -sS -o /dev/null -w '%{time_connect}\n' -m 8 https://inference.wiline.com/v1/models; done | sort -n | awk '{a[NR]=$1} END{printf "rules ON — median %.4fs min %.4fs max %.4fs (n=%d)\n", a[int(NR/2)+1], a[1], a[NR], NR}'
sudo iptables -F DOCKER-USER
rules ON  — median 0.1573s  min 0.0940s  max 0.3768s  (n=20)
rules OFF — median 0.0936s  min 0.0911s  max 0.1576s  (n=20)
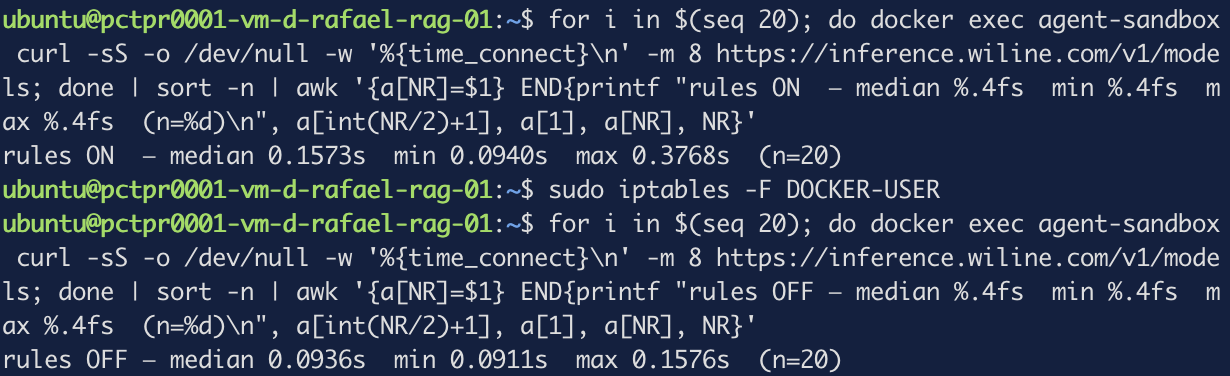
64 milisegundos. Lo cual sería un hallazgo serio, si fuera cierto.
No lo es. Seis reglas de coincidencia de paquetes son microsegundos de trabajo del kernel, y los
mínimos delatan el truco: 0.0940 frente a 0.0911, casi idénticos. La ruta rápida es la misma
en ambas ejecuciones. Toda la diferencia vive en la cola.
El time_connect de curl se mide desde el inicio de la petición y por tanto incluye la
resolución del nombre. La primera ejecución pagó una ida y vuelta completa a 8.8.8.8. Para
la segunda, el resolvedor ya tenía la respuesta en caché. Medimos el orden en que las
ejecutamos.
Mide solo la conexión TCP, restando la resolución:
for i in $(seq 30); do docker exec agent-sandbox curl -sS -o /dev/null -w '%{time_namelookup} %{time_connect}\n' -m 8 https://inference.wiline.com/v1/models; done | awk '{print ($2-$1)}' | sort -n | awk '{a[NR]=$1} END{printf "connect-only median %.5fs min %.5fs max %.5fs (n=%d)\n", a[int(NR/2)+1], a[1], a[NR], NR}'
rules ON  — connect-only median 0.07098s  min 0.06999s  max 0.08607s  (n=30)
rules OFF — connect-only median 0.07102s  min 0.06996s  max 0.07214s  (n=30)
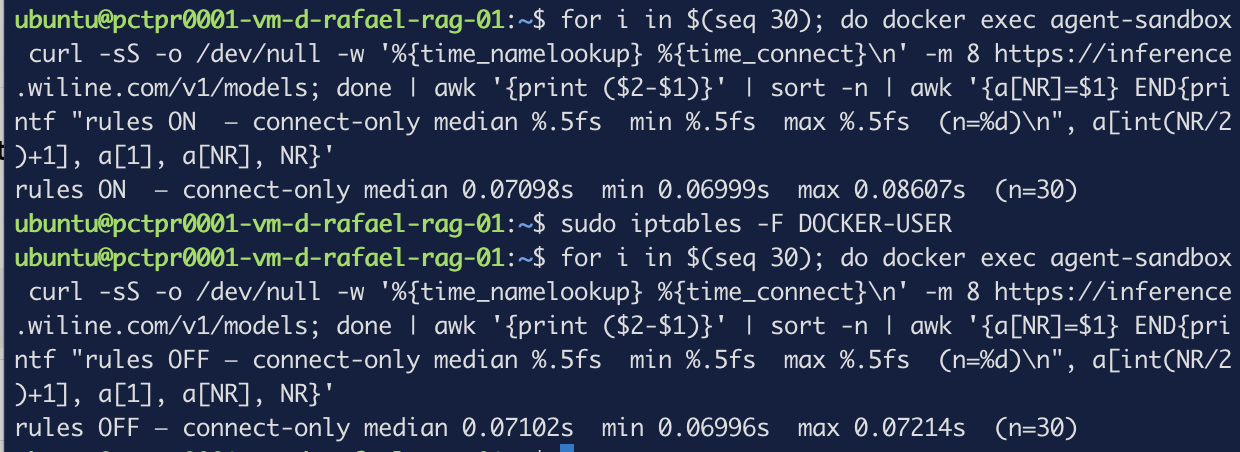
Una diferencia de mediana de −0,04 ms. Negativa: la ruta protegida midió marginalmente más rápido, que es el aspecto que tiene el ruido. Todo cae dentro de unos ±40 µs.
Así que la respuesta honesta no es un número con un signo más delante. Es que el coste de esta política está por debajo de lo que este método puede resolver — y que la versión ingenua de la misma medición se equivocaba por tres órdenes de magnitud, en la dirección que te habría convencido de no desplegarla.
Paso 5 — Sobrevivir a un reinicio
Las reglas de iptables viven en memoria. Ese -F del paso anterior le hizo a la política
exactamente lo mismo que le hace un reinicio.
El reflejo es iptables-persistent, y aquí es la herramienta equivocada: guarda la tabla entera
incluidas todas las reglas que generó Docker, y Docker vuelve a generarlas él mismo al arrancar.
Acabas con duplicados y con un orden que nadie eligió.
Lo que quieres es una unidad que sea dueña solo de tus reglas y que se ejecute después de Docker:
#!/usr/bin/env bash
# Lista de permitidos de salida para el bridge del agente. Se reaplica tras arrancar Docker.
set -euo pipefail

BR=br-agent
DNS="8.8.8.8 8.8.4.4"
API=$(getent hosts inference.wiline.com | awk '{print $1; exit}')

# Elimina solo nuestras propias reglas, para que sea seguro ejecutarlo dos veces.
# `|| true` importa: con la cadena limpia, grep sale con 1 y abortaría el script.
existing=$(iptables -S DOCKER-USER | grep " -i ${BR} " || true)
if [ -n "${existing}" ]; then
  printf '%s\n' "${existing}" | sed 's/^-A /-D /' |
    while read -r rule; do iptables ${rule} || true; done
fi

for d in ${DNS}; do
  iptables -I DOCKER-USER -i "${BR}" -p udp --dport 53 -d "${d}" -j ACCEPT
  iptables -I DOCKER-USER -i "${BR}" -p tcp --dport 53 -d "${d}" -j ACCEPT
done
iptables -I DOCKER-USER -i "${BR}" -p tcp --dport 443 -d "${API}" -j ACCEPT
iptables -A DOCKER-USER -i "${BR}" -j DROP
[Unit]
Description=Egress allowlist for the agent bridge
After=docker.service
Requires=docker.service

[Service]
Type=oneshot
RemainAfterExit=yes
ExecStart=/usr/local/sbin/agent-egress.sh

[Install]
WantedBy=multi-user.target
sudo chmod +x /usr/local/sbin/agent-egress.sh
sudo systemctl daemon-reload && sudo systemctl enable --now agent-egress.service
Demuestra que es idempotente reiniciándola y comparando la cadena consigo misma:
sudo systemctl restart agent-egress.service && sudo iptables -S DOCKER-USER
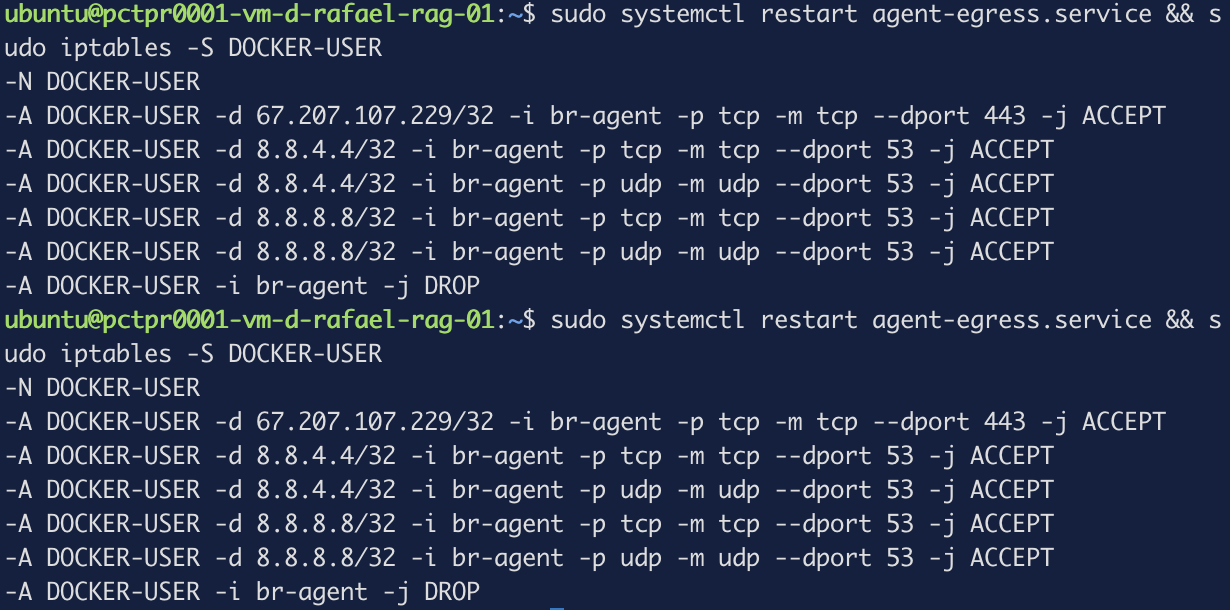
Seis reglas, dos veces, sin duplicados.
Dos cosas que esto te da de forma discreta. getent se ejecuta en cada arranque, así que la
dirección de la API se vuelve a resolver al iniciar — no de forma continua, pero sí la mayor
parte barata del problema del destino móvil, sin ningún demonio extra. Y el bucle de borrado
elimina solo las reglas que coinciden con -i br-agent, así que la unidad nunca toca nada más
de la cadena.
Puedes poner una política de denegación por defecto delante de un contenedor, permitir exactamente los destinos que necesita, distinguir un fallo de DNS de un fallo de socket leyendo el error, medir el coste sin engañarte, y hacer que todo sobreviva a un reinicio.
Si cambias Docker al backend de nftables
Docker 29 incluye un backend de firewall nftables junto al de iptables. No es el predeterminado y este artículo no lo ejecutó — el cambio reconstruye todas las reglas del host, y verificar el comportamiento completo exige un reinicio. Lo que sigue viene de la documentación de Docker, y se marca como tal.
Todo lo anterior deja de aplicarse, porque:
In Docker's nftables implementation, there is no
DOCKER-USERchain.
En su lugar creas tu propia tabla, y la prioridad hace el trabajo que hacía DOCKER-USER:
If your rules need to run before Docker's rules, give the base chains a lower priority number than Docker's chain.
Y una regla que bajo iptables sería definitiva, no lo es:
In nftables, an "accept" rule is not final. It terminates processing for its base chain, but the accepted packet will still be processed by other base chains, which may drop it.
Para sobreponerse al drop de Docker hace falta entonces --bridge-accept-fwmark.
La trampa que conviene conocer es la transición, y es silenciosa en ambos sentidos:
When starting the daemon with nftables after running with iptables, Docker will not remove the jump from the
FORWARDchain toDOCKER-USER. So, rules created inDOCKER-USERwill continue to run until the jump is removed or the host is rebooted. When starting with nftables, the daemon will not add the jump. So, unless there is an existing jump, rules inDOCKER-USERwill be ignored.
Cambia de backend y tu política sigue funcionando — hasta el siguiente reinicio, cuando deja de
hacerlo en silencio. iptables -S DOCKER-USER seguirá listando todas las reglas.
Resolución de problemas — los errores que produjo esta ejecución
La unidad de systemd falla en su primera ejecución y funciona en la segunda
status=1/FAILURE y nada más en el journal. La causa es la línea de limpieza: con la cadena
vacía, grep no encuentra reglas coincidentes y sale con 1, y set -euo pipefail convierte
eso en un aborto antes de añadir ninguna regla. La guarda de idempotencia rompe justo la única
ejecución que no necesita idempotencia. Mira el || true del paso 5.
Todo expira, incluso lo que permitiste
Comprueba si el fallo dice "Resolving" o "Connection". Si dice Resolving, el problema es tu
regla de DNS y nunca se llegó a la regla del destino. Los contenedores a menudo no usan el
resolvedor que esperas — lee /etc/resolv.conf dentro del contenedor, no en el host.
Las reglas están listadas pero no se filtra nada
Comprueba que el bridge esté levantado: ip -br link show br-agent. Una red sin contenedores
conectados tiene la interfaz DOWN, y una regla con -i sobre ella no coincide con nada.
Todo tarda exactamente ocho segundos en fallar
Eso es DROP comportándose correctamente. Usa REJECT mientras iteras si prefieres fallar
rápido.
La medición muestra decenas de milisegundos de sobrecoste
Estás midiendo DNS. Usa %{time_connect} menos %{time_namelookup}, y sospecha de cualquier
resultado donde los mínimos coincidan y las medianas no.
Qué te dio esto y qué no
Hecho: un contenedor que puede alcanzar exactamente un destino y un resolvedor; un intento de exfiltración que falla después de una resolución DNS correcta y no antes; una política que se reaplica sola tras un reinicio y que vuelve a resolver su destino al hacerlo; y un coste medido indistinguible de cero.
Sin hacer:
- El DNS sigue siendo un canal de exfiltración. Permitimos consultas a
8.8.8.8, y se pueden colar datos dentro de ellas. Cerrar eso significa un resolvedor propio y una regla que apunte solo a él — que es otro artículo. - La lista de permitidos es una IP, y las IP se mueven. La unidad vuelve a resolver al arrancar, que no es lo mismo que seguir a una CDN. Un proxy de reenvío que filtre por SNI de TLS es la respuesta honesta para un destino que rota; también es bastante más maquinaria.
- Esto protege contenedores. Los agentes de la parte 3 de orquestación y de la parte 4 corren como procesos del host, donde estas reglas no aplican. Moverlos a un contenedor es el requisito previo, y merece la pena por sí mismo.
- El host no está restringido, ni tampoco ningún otro contenedor de esta máquina. Otros cinco
bridges siguen teniendo un
ACCEPTincondicional enDOCKER-FORWARD. - Nada de esto detiene la inyección. Detiene la salida de la carga útil. Son trabajos distintos.
Qué viene después
La secuela obvia es el resolvedor: monta uno propio, apunta el contenedor a él, permite el puerto 53 solo hacia esa dirección, y el canal de DNS se cierra junto con la dependencia de Google. También prepara el terreno para hacer bien las listas de permitidos por dominio, que es la parte del problema del destino móvil que este artículo deja abierta.