Desarrollo guiado por especificaciones: ¿es la solución al Vibe Coding?

Desarrollo guiado por especificaciones, probado
Alguien publicó el desarrollo guiado por especificaciones en LinkedIn esta semana como la respuesta al vibe coding — a hacerle prompts a un agente, entendiendo a medias lo que estás construyendo, y terminar con código del que no puedes responder. El kit enlazado tiene 127.000 estrellas y viene de GitHub mismo. El argumento convence.
Así que lo instalé y lo apunté a una tarea deliberadamente trivial. Uno de los tres principios que escribió para mí fue una política de dependencias que nunca pedí — guarda ese pensamiento.
Veinte minutos no son un veredicto, sin embargo. Dos ingenieros lo han probado de verdad, en problemas reales, durante suficiente tiempo para que se vean las costuras. Usaron herramientas distintas, en continentes distintos, con siete meses de diferencia — y ambos recurrieron a la misma comparación, sin que nadie se lo pidiera: la última vez que nuestra industria intentó generar código funcional a partir de documentos. En la única pregunta que decide si algo de esto sobrevive al contacto con funcionalidades de IA, se contradicen rotundamente. Ninguno de los dos tiene una medición.
Qué es el desarrollo guiado por especificaciones
Si el término es nuevo para ti, la idea es simple. En lugar de hacerle prompts a un agente e iterar hasta que el código se vea bien, escribes primero una especificación estructurada — qué estás construyendo, por qué, y qué significa "terminado" — y el agente trabaja a partir de ese documento en lugar de tu prompt. La especificación, no el código, se convierte en aquello a lo que todos señalan.
Spec Kit es la implementación de GitHub. Se instala en un repositorio una vez, no por tarea,
y le da a tu agente un conjunto de comandos: constitution para fijar los principios del
proyecto, y luego specify, plan, tasks, implement. Nada corre en segundo plano — deja
plantillas y definiciones de comandos en tu proyecto, y a partir de ahí estás hablando con tu
agente. Más cerca de una configuración de linter que de un producto.
Antes de todo eso, sin embargo, viene constitution — escrita primero, antes de que nadie haya
visto el problema, y todo lo que viene después se juzga contra ella. Guarda eso también.
El paso de instalación te dice a qué apunta realmente:
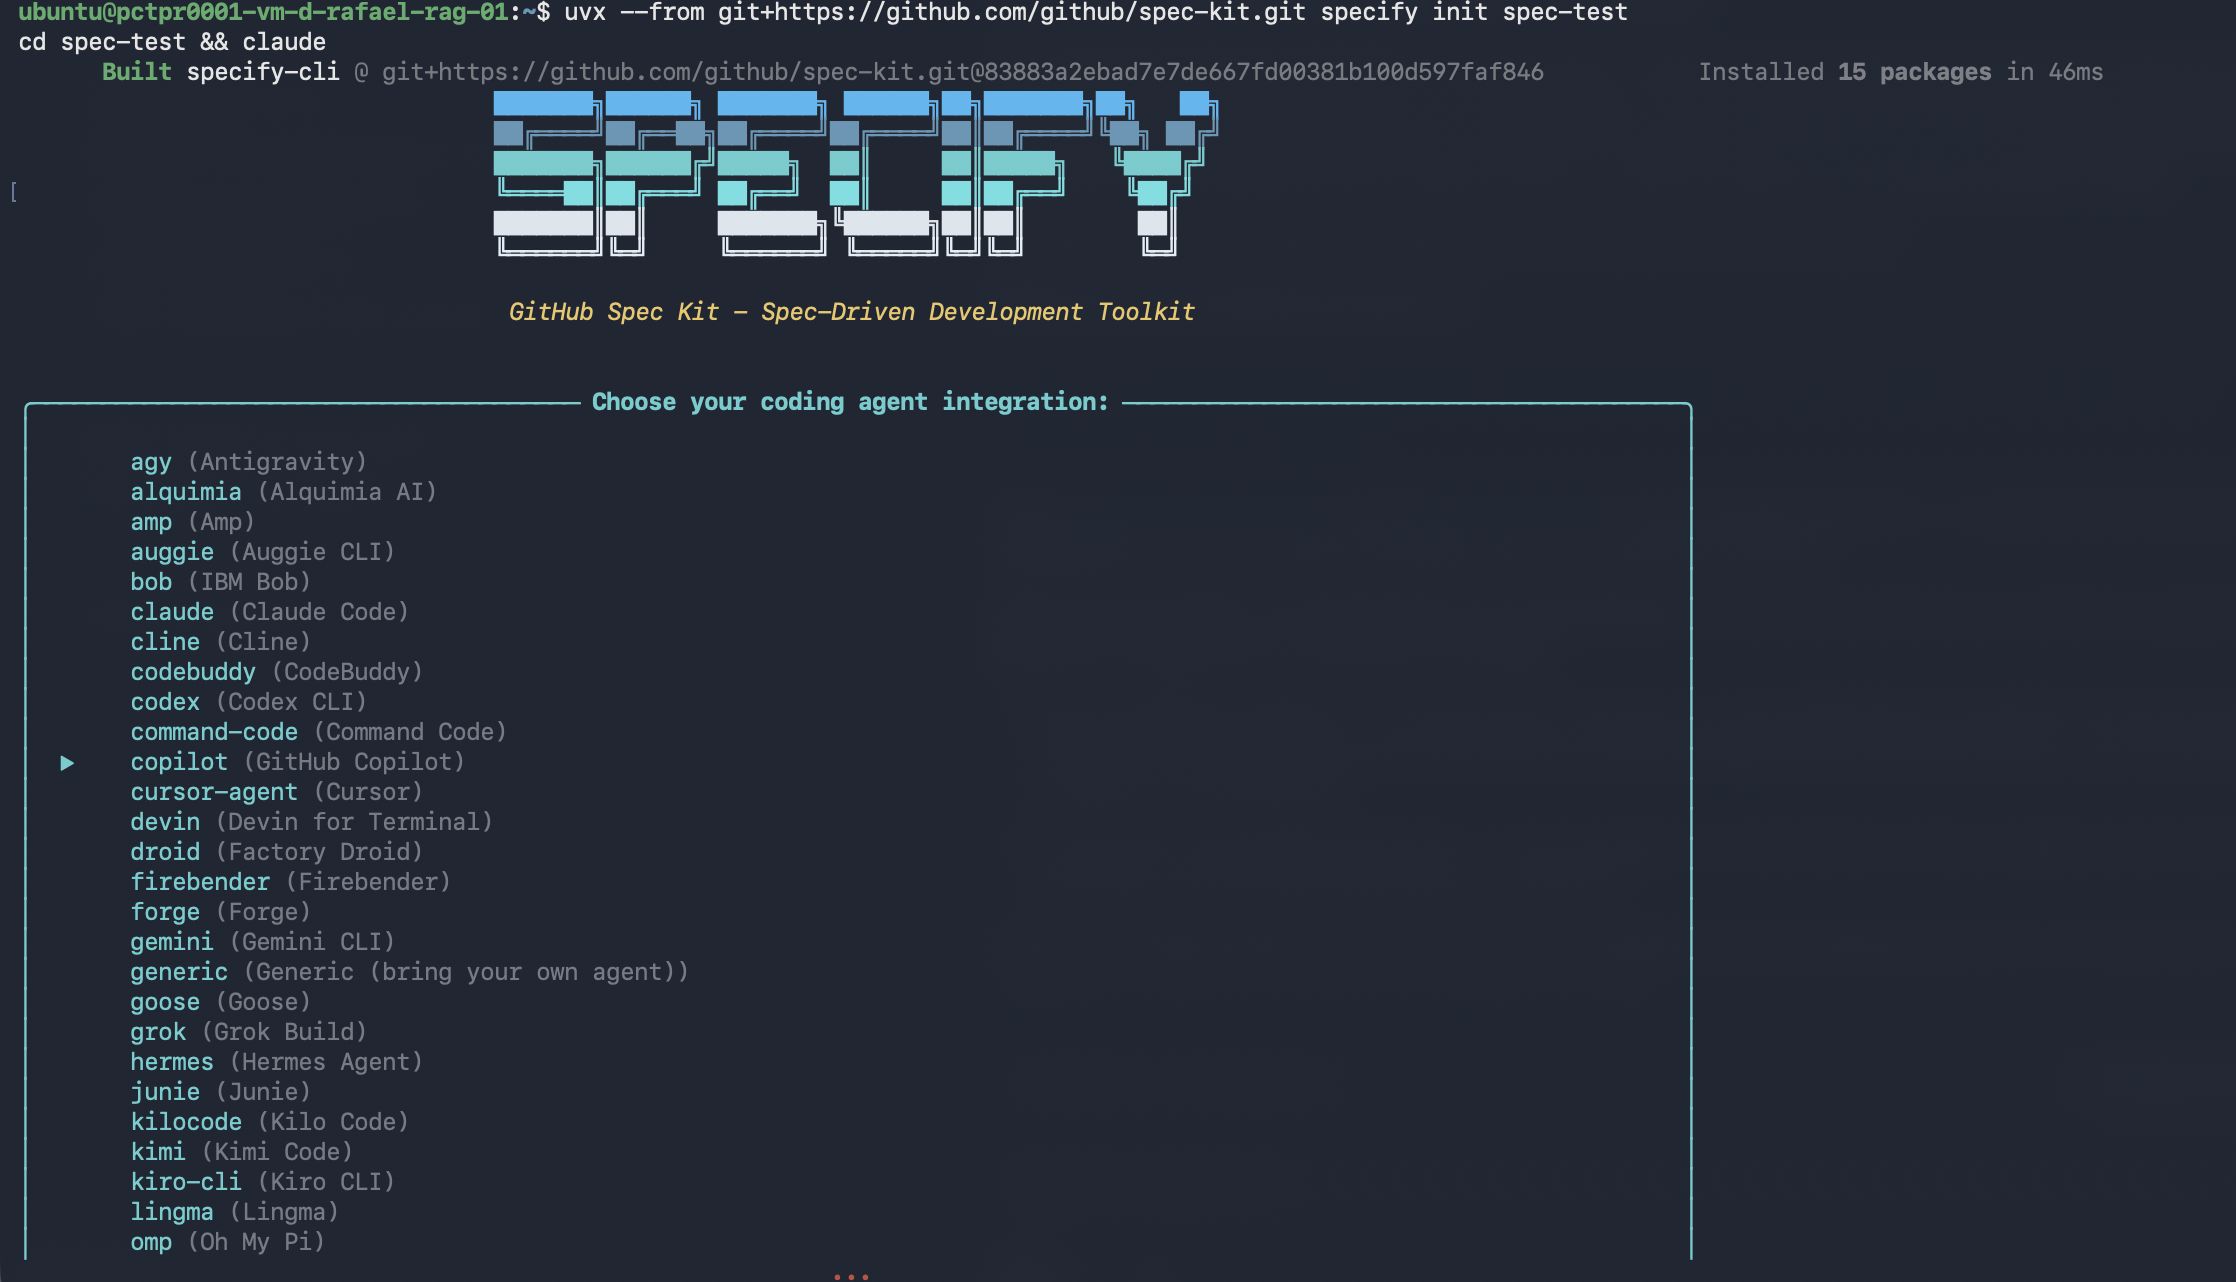
Más de treinta agentes. Esta no es una herramienta solo para GitHub — quiere ser la capa a la que se conecta todo agente de programación, lo que explica bastante el número de estrellas.
Qué pasa realmente cuando lo usas
Birgitta Böckeler, Distinguished Engineer en Thoughtworks, probó tres de estas herramientas a mano — Kiro, Spec Kit y Tessl — y publicó lo que encontró en octubre de 2025.
Le pidió a Kiro que arreglara un error pequeño. Produjo cuatro historias de usuario y dieciséis criterios de aceptación, incluyendo — literalmente — "Como desarrollador, quiero que la función de transformación maneje los casos límite con elegancia, para que el sistema siga siendo robusto cuando se introduzcan nuevos formatos de categoría." Su resumen: "como usar un mazo para partir una nuez."
Con Spec Kit y una funcionalidad real — unos días de trabajo, según su propia estimación — nunca terminó la implementación, y calcula que podría haber construido la cosa a mano en el tiempo que pasó revisando artefactos. La frase que resonará con cualquiera que haya hecho una revisión de código:
Para ser honesta, preferiría revisar código que todos estos archivos markdown.
También encontró al agente ignorando los documentos que debían guiarlo. El paso de investigación de Spec Kit catalogó correctamente las clases existentes; el agente entonces leyó esas descripciones como una especificación y generó las clases otra vez, duplicadas. Y el fallo inverso — el agente yéndose "muy por encima porque estaba siguiendo las instrucciones con demasiado entusiasmo (por ejemplo, uno de los artículos de la constitución)."
Alex Punnen fue más estrecho y más profundo, y publicó la transcripción completa con citas por línea. Spec Kit v0.8.9, en un problema a escala real: consultar datos de elevación de Estados Unidos en 1.756 mosaicos de mapa — 23 mil millones de mediciones, 180 GB.
Su hallazgo es más sutil que "la herramienta inventa cosas". Pidió principios que cubrieran calidad de código, pruebas, consistencia y rendimiento, y dice claramente: "Los principios en sí mismos son razonables." Lo que salió mal, argumenta, es que uno de ellos inclinó silenciosamente todas las decisiones posteriores:
Las nuevas dependencias DEBEN justificarse por escrito: problema resuelto, alternativas consideradas, licencia verificada.
Sensato en aislamiento. Pero como lo plantea Punnen, "la opción de la biblioteca estándar siempre gana los empates porque cuesta cero entradas de justificación." Cuatro fases después el plan eligió SQLite porque — primera razón listada — "Biblioteca estándar, cero dependencias nuevas… esa es la respuesta más barata posible." Tres de las cuatro alternativas rechazadas cayeron por esa misma regla. Su veredicto: "La constitución hizo el rechazo; el agente solo era el micrófono."
Luego viene la parte que me costó más quitarme de encima. Antes en el proceso el agente había escrito un presupuesto de rendimiento de cinco minutos en la especificación — un número que adivinó, sin ninguna medición detrás, archivado bajo la etiqueta SC-008. Más tarde, esa adivinanza volvió como la razón por la que no se podía usar un mejor diseño: "El costo de transcodificación se pasa de SC-008." Solo bajo presión directa concedió: "Tienes razón en que sobrevaloré la razón #2." El mejor diseño, escribe Punnen, no necesitaba nada que no estuviera ya en la especificación, "excepto la disposición a revisar un número arbitrario que la propia especificación produjo."
Su resumen de esa fase se aplica a toda la categoría:
El artefacto parece terminado porque cada casilla de la plantilla está llena — no porque la pregunta de ingeniería esté respondida.
Dos cosas hacen que esto sea más que un caso aislado. Su prompt de constitución era esencialmente el propio ejemplo documentado de GitHub, ligeramente adaptado — siguió la guía rápida. Y la resistencia que encontró es en parte por diseño: el documento de metodología de GitHub llama a la constitución "un conjunto de principios inmutables," con una sección titulada "El poder de los principios inmutables."
Para ser precisos, el presupuesto de cinco minutos no era un principio constitucional — era un criterio de éxito que el agente generó a partir de uno. El documento nunca afirma que esos sean inmutables. Pero el número cargó esa autoridad de todos modos, y hizo falta un humano para desalojarlo. La metodología argumenta a favor de fijar principios y no dice nada sobre qué pasa cuando las adivinanzas derivadas de ellos heredan la misma jerarquía.
Los tres niveles en los que nadie está de acuerdo
La contribución más útil de Böckeler es una distinción que el resto del debate se salta. "Desarrollo guiado por especificaciones" cubre tres prácticas diferentes:
Su veredicto sobre dónde están realmente las herramientas: "Todos los enfoques y definiciones de SDD que he encontrado son spec-first, pero no todos aspiran a ser spec-anchored o spec-as-source." Incluido Spec Kit. La metodología de GitHub aspira mucho más alto — "Las especificaciones no sirven al código—el código sirve a las especificaciones" — pero Spec Kit crea una rama por especificación, así que una especificación vive lo que dura una solicitud de cambio, no una funcionalidad. Su conclusión: "spec-kit sigue siendo lo que yo llamaría spec-first solamente, no spec-anchored en el tiempo."
Vale saber que IBM publicó la taxonomía idéntica de tres niveles siete meses después, con nota al pie. Si la has visto atribuida a IBM, es de ella.
Lo que obtuve en una tarea trivial
Ejecuté Spec Kit en el commit 83883a2 con un prompt deliberadamente mínimo — "Principios para
una pequeña utilidad de Python. Mantenlo mínimo — no tengo restricciones fuertes."
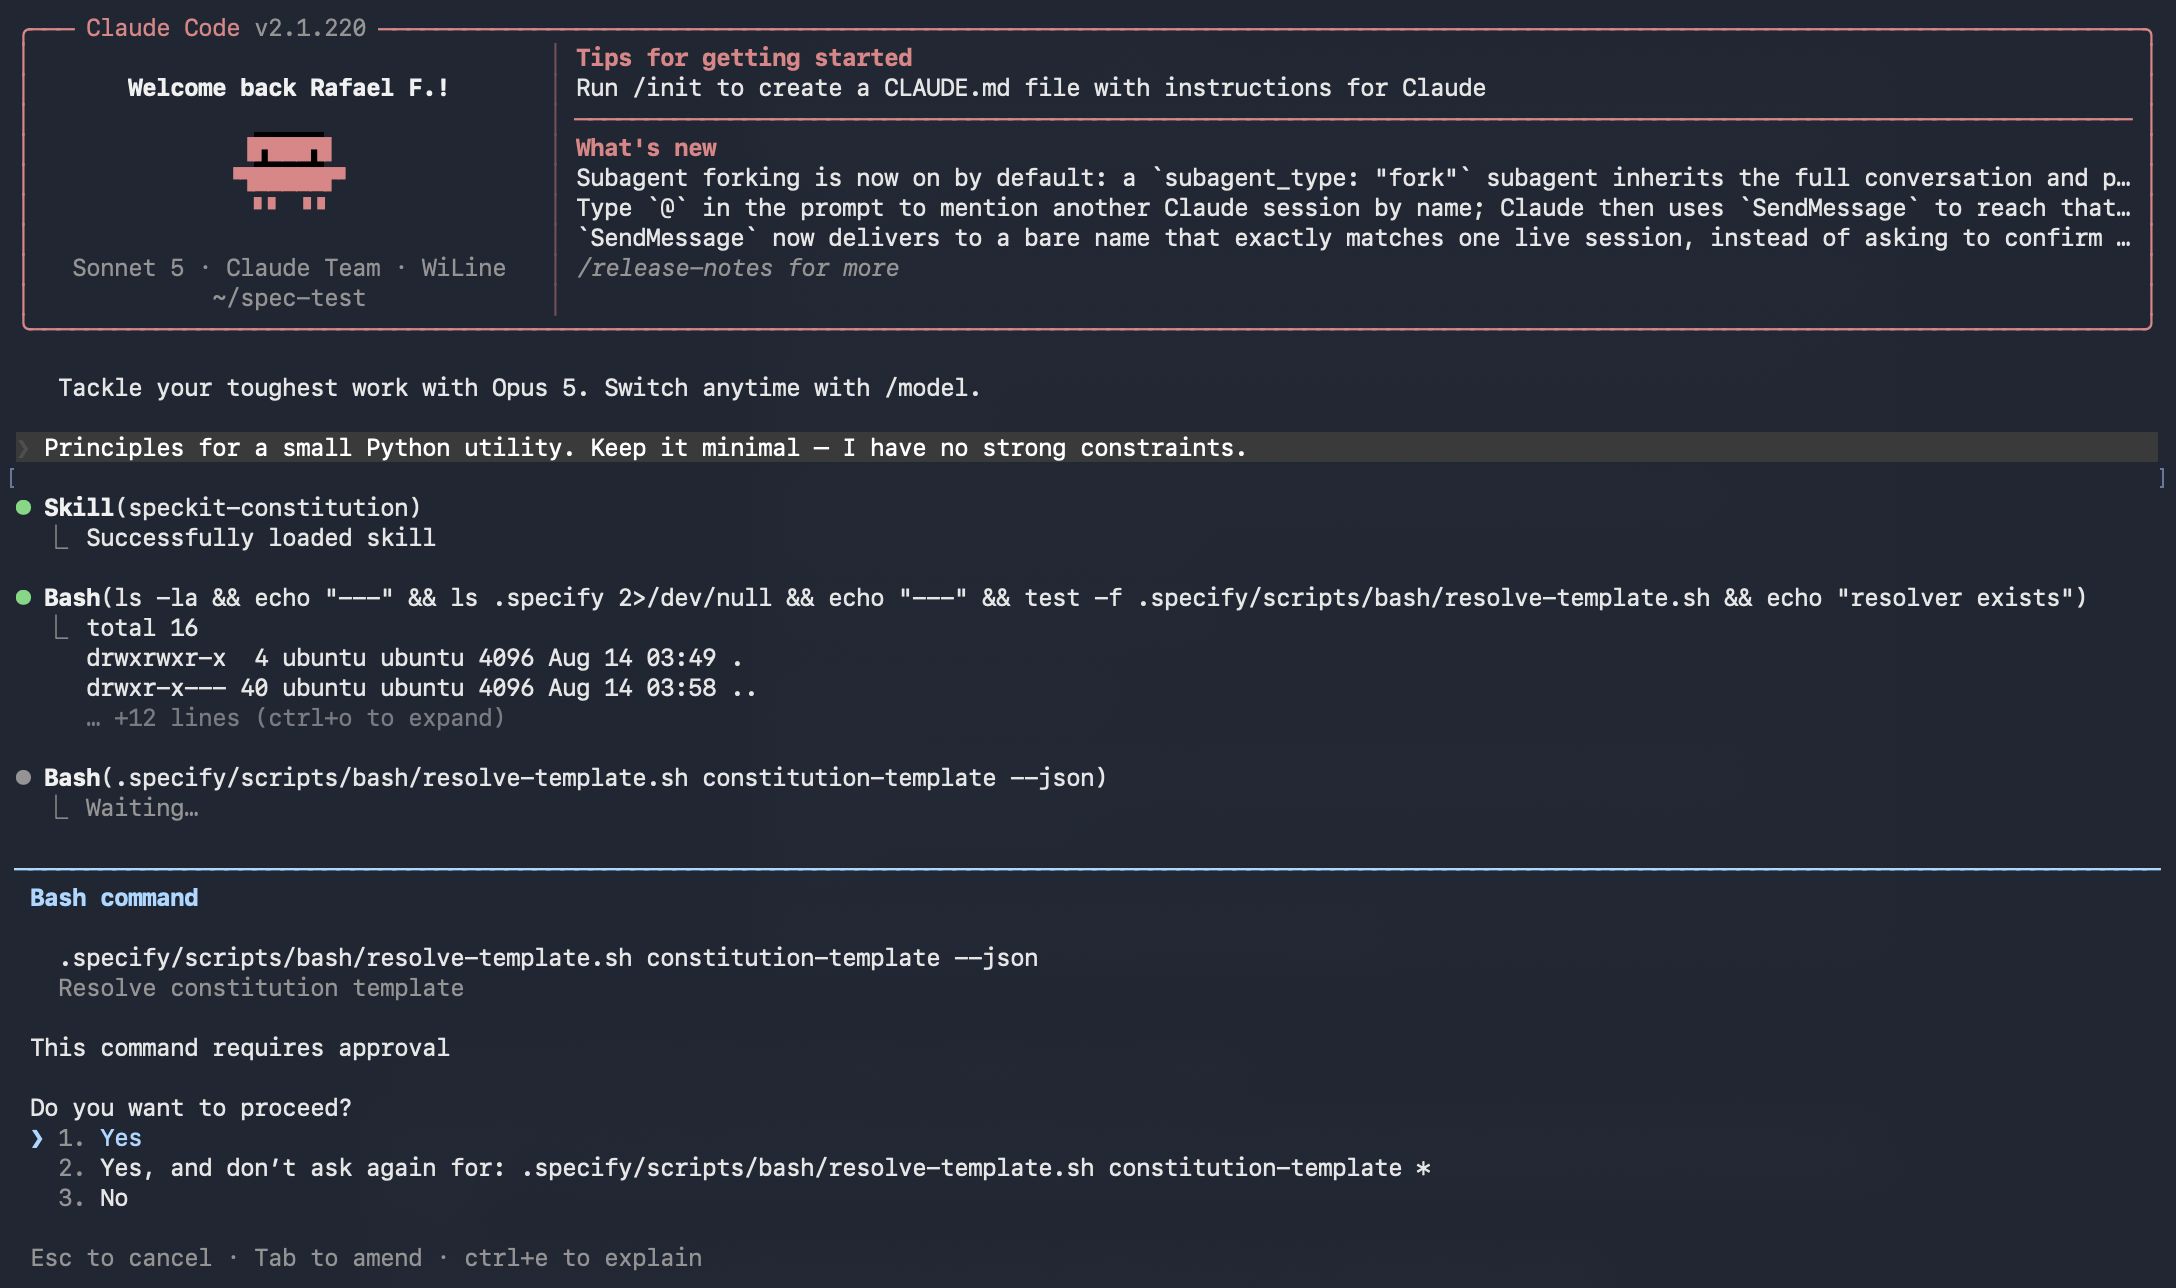
Uno de los tres principios que escribió:
### II. Minimal Dependencies
Prefer the Python standard library. A third-party dependency MAY be added only when it
removes clearly more complexity than it introduces, and MUST be recorded in the project's
dependency file (e.g. `requirements.txt` or `pyproject.toml`).
Una política de dependencias, escrita en el lenguaje MUST/MAY de un estándar formal, a partir de un prompt donde dije que no tenía restricciones. No está en la plantilla local ni en el archivo de skill — pero el Artículo I de los nueve artículos constitucionales de GitHub sí pide implementaciones "con límites claros y dependencias mínimas." Así que es consistente con la filosofía publicada más que inventado en el momento. No puedo decirte el mecanismo, solo qué entró y qué salió.
Una ejecución, una tarea trivial, y no me costó nada porque no había nada en juego. El caso de Punnen muestra lo que cuesta este tipo de sesgo cuando el problema es lo bastante difícil para que se equivoque. El mío solo muestra que aparece sin que se lo pidan — lo que importa porque, como señala Böckeler, la constitución de Spec Kit es su banco de memoria, "un archivo de reglas muy poderoso" aplicado a cada cambio. Una preferencia no solicitada no se queda en un documento que vas a descartar. Se convierte en una regla permanente.
Los dos recurrieron a los años noventa
Esto es lo que me convenció de que vale la pena tomarlo en serio en lugar de descartarlo o evangelizarlo.
Böckeler, que trabajó en desarrollo guiado por modelos al inicio de su carrera, ve MDD:
Me pregunto si spec-as-source, e incluso spec-anchoring, podrían terminar con las desventajas tanto de MDD como de los LLMs: inflexibilidad y no determinismo.
Punnen, veinte años en telecomunicaciones, recurre independientemente a Rational Rose y UML — "tratado como la bala de plata de su década: dibuja cajas, flechas y diagramas, y la herramienta mágicamente los convertiría en código funcional."
Ninguno cita al otro. Herramientas distintas, problemas distintos, países distintos. Ambos aterrizan en la misma época: la última vez que nuestra industria creyó que un documento podía ser la fuente y el código el resultado.
Böckeler es cuidadosa con la comparación — "No siento nostalgia por mi experiencia con MDD." Su punto es que las herramientas de hoy dejan atrás las partes que hacían doloroso a MDD: ya no necesitas un lenguaje especial de especificación ni un generador hecho a medida. Lo que se pregunta es si el intercambio es bueno, ya que el enfoque antiguo al menos producía la misma salida cada vez.
Punnen nombra la trampa que hay debajo:
La especificación tiene que ser muy rigurosa desde el principio, pero para volverse rigurosa necesita refinarse iterativamente junto con el código generado.
Un Catch-22, en otras palabras: según él no puedes escribir una especificación rigurosa para un problema que aún no entiendes, y el entendimiento llega mientras construyes. Rastrea la idea hasta Fred Brooks, cuarenta años atrás: "las descripciones de una entidad de software que abstraen su complejidad a menudo abstraen su esencia."
Dónde discrepan — y por qué te importa
En una pregunta estos dos están en oposición directa.
Böckeler, generando código repetidamente a partir de una especificación de Tessl: "He visto el no determinismo en acción… un ejercicio interesante iterar sobre la especificación y hacerla cada vez más específica para aumentar la repetibilidad de la generación de código."
Punnen: "Esto no es un problema mayor en la práctica. Los frameworks de SDD actúan como prompts estructurados, y los modelos modernos producen salidas muy consistentes cuando son guiados por ellos."
GitHub se pone del lado de Punnen y va más lejos, afirmando "Consistencia entre LLMs: modelos de IA diferentes producen código arquitectónicamente compatible." No el mismo modelo dos veces — modelos diferentes. Sin evidencia ofrecida.
Dos ingenieros experimentados, conclusiones opuestas, una afirmación de proveedor más fuerte que cualquiera de las dos, y ni un número entre ellos. Importa más de lo que parece. Mantener una especificación y su código sincronizados — la idea de spec-anchored — depende de pruebas automatizadas que atrapen la deriva. Eso funciona para código determinista, donde la misma entrada da la misma salida.
Apúntalo a una funcionalidad de LLM y la verificación deja de funcionar. assert response == expected no significa nada cuando la respuesta difiere en cada ejecución. A menos que cambies
pruebas por evaluaciones, donde cada criterio de aceptación se convierte en una afirmación
puntuada: ¿clasificó correctamente, devolvió JSON válido contra el esquema, se negó cuando debía?
Ese puente sobrevive al no determinismo, y es el arnés que he pasado varios tutoriales construyendo sobre la WEC Inference API. También hace que el desacuerdo sea medible: escribe la especificación, convierte sus criterios en afirmaciones de evaluación, y ejecútalas a lo largo de una sesión larga para ver si la adherencia se mantiene o decae.
Ese es el siguiente post.
Si vas a probarlo
Las conclusiones prácticas de Punnen son mejores que cualquier cosa que yo inventara, y se las ganó:
- Trata las reglas de "sin dependencias nuevas" como sesgos, no como neutrales. Si la respuesta correcta necesita una dependencia, vas a tener que defenderla — el framework no lo hará.
- Trata los criterios de éxito generados como adivinanzas hasta que un ingeniero los ratifique. El agente te los va a citar después como si estuvieran medidos.
- Lee cada menú de aclaración como una propuesta de diseño disfrazada. Si la opción que quieres no está listada, ese es el fallo — no una invitación a elegir la mejor de tres.
- Presiona durante la aclaración, no durante el plan. Los planes son largos, internamente consistentes, y agotadores de revisar.
Una mía: escribe tus principios con una fecha y una justificación, para que un tú posterior pueda reemplazarlos. IBM sugiere tratar las especificaciones como "artefactos versionados apilables, como registros de decisiones de arquitectura" — y un ADR es algo que puedes marcar como reemplazado. La metodología llama a estos principios inmutables. Tu problema no lo es.
Añade la prueba de costo de IBM, la línea práctica más afilada que escribió cualquiera de ellos: el costo de refinar la especificación debería ser siempre menor que el costo de arreglar malentendidos en la implementación. Cuando ese equilibrio se invierte, deja de pulir y empieza a construir.
Y revisa la organización antes de instalar. El repositorio que circula en LinkedIn es un fork
con once estrellas; el proyecto real es
github/spec-kit. Eso importa más aquí que en la mayoría de
herramientas: el trabajo de Spec Kit es escribir archivos de instrucciones que tu agente después
obedece, y en la primera ejecución apruebas esa carpeta con una tecla sin haberlos leído.
Entonces, ¿reemplaza al vibe coding? No de la forma que sugiere el argumento de venta. No ayuda cuando no entiendes tu problema — ayuda cuando lo entiendes y lo comunicas mal. Esos son fallos diferentes, y solo uno de ellos tiene plantilla.
Ambos encontraron valor real en las fases iniciales — Punnen califica el paso de aclaración como el más útil de todos — y ambos encontraron que los artefactos se veían más autoritativos exactamente donde las decisiones debajo de ellos eran más arbitrarias. Punnen: "son más peligrosos cuando parecen más rigurosos."
Böckeler recurre a una palabra compuesta alemana para describirlo — Verschlimmbesserung. Empeorar algo en el intento de mejorarlo.
La parte difícil nunca fue escribir el código.