Saltar al contenido principal

14 publicaciones etiquetados con "ai-news"

Ver Todas las Etiquetas

Jev: un modelo de decisión que pones delante de tus LLM para enrutar el tráfico

· 7 min de lectura

Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Enrutado · AI News

Jev decide, tus LLM responden

Llega una peticiónEl modelo correcto, en 127 ms

TypeSafe lanzó su primer modelo el 15 de septiembre, y lo interesante de Jev es lo que se niega a hacer. No te escribe un párrafo. Le das una petición y te devuelve un valor estructurado — una etiqueta, una clase, una decisión — en, según ellos, 70 a 500 ms. La frase más clara del post es de su fundador, Diogo Almeida: "Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out."

La mayoría de los modelos están hechos para hablar con personas. Jev está hecho para que lo llame el código — y el primer trabajo que le encaja esa forma es el enrutado.
El bug que redujo a la mitad el throughput de un gateway sin un solo error

· 6 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Gateways · AI NewsUn gateway perdiendo la mitad de su throughput sin reportar errores

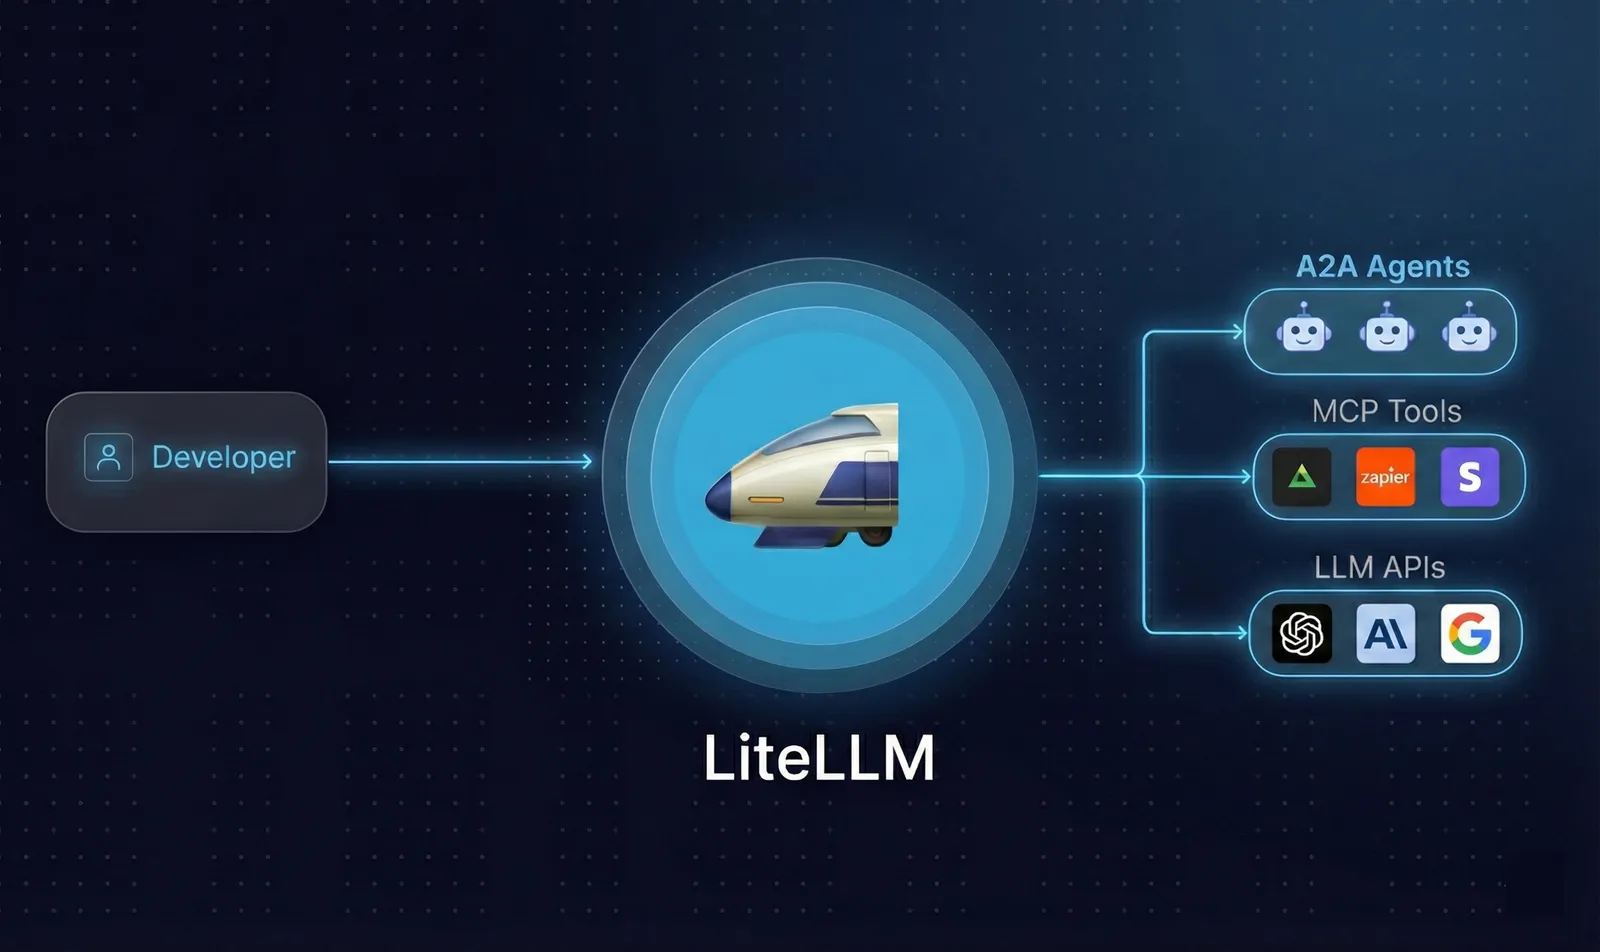
Pfizer opera un gateway de IA — el único servicio con el que habla cada herramienta interna cuando quiere un modelo. Durante una verificación rutinaria de actualización, su throughput cayó a la mitad. Sin errores. Sin peticiones fallidas. Nada raro en ningún dashboard.

Publicaron lo que encontraron junto al equipo de LiteLLM, y la causa es lo bastante pequeña como para caber en un párrafo: alguien escribió una opción que decía no cifres esta conexión, y el sistema la cifró igual.

El Arreglo de MCP para los Catálogos de Herramientas Inflados Tiene una Factura — Y Está en los Docs, No en el Roadmap

· 8 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Protocolos · Noticias de IADescubrimiento progresivo de herramientas y la caché de prompt del proveedor

El roadmap actual de los mantenedores de MCP nombra un problema que la mayoría de quienes construyen agentes ha sentido sin medirlo: el catálogo de herramientas de un servidor se le cobra al modelo antes de que alguien pregunte nada. Bajo Improved primitives, el artículo es directo al respecto — "Connecting to a server with a hundred tools means the model pays for that entire surface before the user has asked a single question, and tool selection tends to get worse as the list grows."

Lo que hace que esto valga la pena no es el roadmap. Es que el arreglo ya está escrito, en la documentación de clientes, junto a una advertencia de que puede costar más que el problema que resuelve — y esa advertencia recibe mucha menos atención que el arreglo al que pone condiciones.

LangChain Acaba de Hacer MCP de Primera Clase — Lo Ejecutamos el Mismo Día, y Tres Cosas Todavía No Funcionan

· 11 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Frameworks de Agentes · Noticias de IAEl soporte de MCP llega al paquete principal de LangChain

En julio la especificación de MCP arrancó las sesiones. Escribimos entonces que el cambio era infraestructura, no changelog — que un núcleo sin estado dejaría a los servidores sentarse detrás de balanceadores de carga corrientes y sobrevivir a los redespliegues, y que los clientes tendrían que ponerse al día.

Hoy LangChain se puso al día. El soporte de MCP salió del paquete separado langchain-mcp-adapters y entró en langchain mismo, reconstruido sobre FastMCP, con dos funciones que la especificación vieja hacía imposibles: elicitación como interrupt de LangGraph y un catálogo de herramientas cacheable.

Lo instalamos esa misma tarde y lo apuntamos a un servidor que escribimos contra la nueva especificación. El anuncio es correcto. El ecosistema alrededor no está listo — y uno de los huecos convierte silenciosamente una puerta de aprobación humana en una frase que el modelo se inventa.

Un agente puede reducir su propia búsqueda web, pero nunca ampliarla

· 5 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Agentes · Noticias de IA

Solo reducir, nunca ampliar

Por favor usa fuentes confiablesLas fuentes confiables son las únicas que hay

Tu agente puede buscar en la web. Escribes en el prompt: usa solo sec.gov y los grandes medios financieros. Normalmente obedece. Las veces que no lo hace son las veces en que aprendes que una línea en un prompt es una petición, no una regla.

El 19 de agosto AWS añadió filtros de sitios a la herramienta de búsqueda web en Bedrock AgentCore. Función pequeña. Pero la forma en que maneja un desacuerdo vale la pena conocerla, porque es lo que la convierte en una barrera en lugar de una nota.

Un router que no puede ver la conversación no puede clasificar "yes"

· 8 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Enrutamiento · Noticias de IA

Clasificando la palabra "yes"

Puntuación este mensajePuntuación lo que aprueba

El trabajo de un router de modelos es leer una solicitud y decidir qué modelo debe responderla. Las preguntas baratas van a un modelo pequeño, las difíciles a uno grande, y la factura baja. Todo el arreglo depende de poder distinguir.

Entonces un usuario escribe "yes".

O "continue". O "hazlo". Nada en estas dos o tres letras dice si el trabajo que se está aprobando es una corrección ortográfica o una migración de base de datos. Un router que puntúa el mensaje actual de forma aislada ve una cadena muy corta sin vocabulario técnico, y hace lo obvio: modelo más barato.

Lo que significa que si rutas las solicitudes para ahorrar dinero, tu nivel más barato probablemente esté absorbiendo trabajo que nunca debería haber visto — y tu cifra de ahorro es en parte falsa. El 4 de agosto LiteLLM publicó un benchmark que mide ambas mitades de eso: qué tan mal se equivoca la ruta, y cuánto cuesta arreglarlo.

Enmascara tus registros, no tus indicaciones

· 8 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Privacidad · Noticias de IA

Enmascara tus registros, no tus indicaciones

Redactar antes del modeloRedactar antes de los registros

Casi cada guía de "asegura tu aplicación LLM" da el mismo consejo: antes de que una indicación llegue al modelo, elimina los datos personales de ella — intercambia nombres, correos electrónicos y números de cuenta por [REDACTED] o <PERSON>, luego llama al modelo.

Suena obviamente correcto. Yo también asumí que lo era. Luego fui y leí la investigación sobre lo que realmente hace el enmascaramiento a un modelo, y los documentos apuntan en la dirección opuesta. La versión corta: enmascara tus registros, no tus indicaciones.

Desarrollo guiado por especificaciones: ¿es la solución al Vibe Coding?

· 14 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Práctica de ingeniería · Noticias de IA

Desarrollo guiado por especificaciones, probado

Escribe el promptEscribe el contrato

Alguien publicó el desarrollo guiado por especificaciones en LinkedIn esta semana como la respuesta al vibe coding — a hacerle prompts a un agente, entendiendo a medias lo que estás construyendo, y terminar con código del que no puedes responder. El kit enlazado tiene 127.000 estrellas y viene de GitHub mismo. El argumento convence.

Así que lo instalé y lo apunté a una tarea deliberadamente trivial. Uno de los tres principios que escribió para mí fue una política de dependencias que nunca pedí — guarda ese pensamiento.

Veinte minutos no son un veredicto, sin embargo. Dos ingenieros lo han probado de verdad, en problemas reales, durante suficiente tiempo para que se vean las costuras. Usaron herramientas distintas, en continentes distintos, con siete meses de diferencia — y ambos recurrieron a la misma comparación, sin que nadie se lo pidiera: la última vez que nuestra industria intentó generar código funcional a partir de documentos. En la única pregunta que decide si algo de esto sobrevive al contacto con funcionalidades de IA, se contradicen rotundamente. Ninguno de los dos tiene una medición.

Muse Glimmer: un modelo agentic de 30B que funciona en una GPU, sin necesidad de centro de datos

· 4 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Modelos · Noticias de IA

Un agente serio, sin necesidad de centro de datos

Agentes solo en la nubeUna GPU, completamente local

La mayoría de los anuncios de modelos "ejecutarlo localmente" vienen con un asterisco: más pequeños, más débiles, una versión de juguete de la cosa real. El lanzamiento más reciente de Meta no lo tiene: Muse Glimmer, un modelo multimodal de 30B construido específicamente para trabajo agentic, cabe en una sola GPU de consumo y supera a modelos más grandes en los benchmarks que realmente miden el comportamiento de los agentes.

'La ingeniería de bucles está muerta' — y la verdadera historia es más extraña que el obituario

· 15 min de lectura
Rafael Fernandes
NLP Engineer & Tech Writer at WiLine
Share:
Arquitectura · Noticias de IA

Bucles, gráficos y el obituario de seis semanas

Ingeniería de buclesIngeniería de gráficos

En junio de 2026, el mundo de la IA obtuvo una nueva palabra de moda: ingeniería de bucles — aproximadamente, el diseño disciplinado de un bucle de llamada a herramientas de un solo agente. Seis semanas después, supuestamente fue reemplazada por ingeniería de gráficos — conectando varios agentes a la vez — asesinada por doce palabras que 3.1 millones de personas vieron:

¿No sabes qué es la ingeniería de bucles? No te preocupes — la mayoría de las personas que la declararon muerta tampoco lo sabían. Aquí están ambos términos, cómo un nombre se convirtió en un obituario en seis semanas, y el giro que nadie verificó antes de escribir sobre ello.